Fundamentos de Machine Learning
Introducción: El Cambio de Paradigma en la Toma de Decisiones
En el capítulo anterior exploramos cómo la Minería de Datos, el Machine Learning y la Inteligencia Artificial se relacionan dentro del ecosistema de datos. Establecimos que el Machine Learning es el motor técnico que permite extraer valor de los datos.
Ahora profundizaremos en los fundamentos teóricos y prácticos del Machine Learning, desmitificando el concepto de “caja negra” para comprenderlo como un conjunto de herramientas matemáticas de aproximación de funciones. Este capítulo sienta las bases técnicas que posteriormente aplicaremos dentro del marco CRISP-DM.
La Pregunta Fundamental
¿Cómo puede una organización transformar datos históricos (“experiencia”) en decisiones futuras más inteligentes? ¿Cómo convertimos la incertidumbre del mercado en riesgo calculable?
La respuesta está en comprender tres elementos fundamentales:
- ¿Qué hace realmente el Machine Learning? (Aproximación de funciones)
- ¿Qué tipos de problemas puede resolver? (Paradigmas de aprendizaje)
- ¿Cómo evaluamos si un modelo es útil? (Sesgo vs. Varianza)
A lo largo del capítulo encontrarás bloques titulados Pregunta para discutir. No los saltes: la sección que sigue a cada uno es la respuesta, y la respuesta se entiende mucho mejor después de haber intentado resolverla.
De la Programación Explícita al Aprendizaje Inductivo
La Limitación de los Sistemas Basados en Reglas
Tradicionalmente, la automatización de procesos de negocio se ha basado en la programación deductiva. En este paradigma, el ingeniero actúa como el “arquitecto” de la lógica: debe comprender explícitamente cada variable y cada contingencia, y luego codificar reglas precisas para manejarlas.
Ejemplo: Aprobación de Crédito Bancario (Década de 1990)
Un sistema experto tradicional operaría bajo reglas estrictas:
SI ingresos > $50,000 Y antigüedad_laboral > 2 años
ENTONCES aprobar_crédito
SINO rechazar_créditoUn banco te entrega su historial de ocho créditos ya cerrados. En equipos de tres, escriban la regla de aprobación que usarían de aquí en adelante.
| # | Ingreso anual | Antigüedad laboral | Deuda / Ingreso | Pagos tarde (2 años) | ¿Pagó el crédito? |
|---|---|---|---|---|---|
| 1 | $85,000 | 8 años | 0.15 | 0 | Sí |
| 2 | $62,000 | 4 años | 0.20 | 0 | Sí |
| 3 | $54,000 | 3 años | 0.25 | 1 | Sí |
| 4 | $95,000 | 6 años | 0.30 | 0 | Sí |
| 5 | $38,000 | 1 año | 0.55 | 3 | No |
| 6 | $45,000 | 2 años | 0.60 | 4 | No |
| 7 | $30,000 | 1 año | 0.45 | 2 | No |
| 8 | $48,000 | 5 años | 0.70 | 5 | No |
Su regla debe clasificar correctamente los ocho casos. Escríbanla en el pizarrón.
Llegan cuatro solicitantes nuevos. Apliquen su regla y anoten qué decidiría. La última columna dice lo que realmente pasó.
| # | Ingreso anual | Antigüedad laboral | Deuda / Ingreso | Pagos tarde (2 años) | ¿Pagó el crédito? |
|---|---|---|---|---|---|
| 9 | $49,000 | 12 años | 0.10 | 0 | Sí |
| 10 | $120,000 | 9 años | 0.75 | 3 | No |
| 11 | $70,000 | 1 año | 0.18 | 3 | Sí |
| 12 | $58,000 | 6 años | 0.30 | 0 | No |
¿Cuántos de los cuatro acertó su regla? ¿Qué le agregarían para arreglarlo?
Al menos tres reglas distintas clasifican perfectamente los ocho casos de entrenamiento:
- Regla A: aprobar si ingreso > $50,000 y antigüedad > 2 años.
- Regla B: aprobar si Deuda / Ingreso < 0.35.
- Regla C: aprobar si pagos tarde ≤ 1.
Las tres aciertan 8 de 8. Ya ahí hay un problema: los datos no alcanzan para decidir cuál regla es la correcta. Distintos equipos escribieron reglas distintas, todas perfectas en el historial, y no hay forma de elegir entre ellas mirando solo esas ocho filas.
Con los cuatro casos nuevos se separan:
| Caso | Regla A | Regla B | Regla C | Realidad |
|---|---|---|---|---|
| 9 — gana $49,000 pero 12 años de antigüedad y casi sin deuda | Rechaza ✗ | Aprueba ✓ | Aprueba ✓ | Pagó |
| 10 — gana $120,000 pero sobreendeudado | Aprueba ✗ | Rechaza ✓ | Rechaza ✓ | No pagó |
| 11 — recién contratado, buen ingreso, atrasos viejos | Rechaza ✗ | Aprueba ✓ | Rechaza ✗ | Pagó |
| 12 — se ve bien en todo | Aprueba ✗ | Aprueba ✗ | Aprueba ✗ | No pagó |
Tres conclusiones, en orden de profundidad:
- Las reglas se multiplican. Cada excepción exige una cláusula nueva, y cada cláusula nueva abre excepciones propias. Con cinco variables ya es incómodo; con las cientos que hoy tiene un banco (comportamiento web, geolocalización, historial transaccional) es imposible.
- Los datos no determinan la regla. Tres reglas incompatibles explicaban igual de bien el pasado. Elegir entre hipótesis que compiten es justamente el problema que resolverá el Machine Learning, y para resolverlo hará falta evaluar en datos que el modelo no vio.
- El caso 12 no lo arregla ninguna regla. Se veía bien en las cinco variables y no pagó, porque perdió el empleo tres meses después de firmar. Esa información no está en ninguna columna y no hay regla, ni modelo, que pueda recuperarla. Guarden esta idea: reaparece en unas páginas como el término \(\epsilon\).
Este enfoque, aunque transparente, es extremadamente frágil:
- ¿Qué sucede con un solicitante que gana $49,000 pero tiene 10 años de antigüedad y cero deudas?
- ¿Cómo manejamos 50 variables adicionales como historial crediticio, comportamiento de compra, y estabilidad residencial?
- ¿Cómo adaptamos las reglas cuando cambia la economía?
A medida que el entorno de negocios se vuelve más complejo —con miles de variables como comportamiento web, geolocalización e historial transaccional— la cantidad de reglas necesarias para capturar la realidad explota exponencialmente, volviéndose inmanejable para la mente humana.
La Definición Formal de Machine Learning
El Machine Learning invierte este proceso. En lugar de suministrar las reglas a la computadora, suministramos:
- Los datos (entradas)
- Las respuestas deseadas (salidas históricas)
Y dejamos que la computadora descubra las reglas por sí misma.
Definición de aprendizaje de máquina
“Se dice que un programa de computadora aprende de la experiencia \(E\) con respecto a alguna clase de tareas \(T\) y medida de rendimiento \(P\), si su desempeño en las tareas en \(T\), medido por \(P\), mejora con la experiencia \(E\).”
Para el ingeniero de negocios, descomponer esta definición en sus tres componentes es vital para identificar oportunidades de ML en la empresa:
| Componente | Definición | Ejemplo: Examen de Economía |
|---|---|---|
| Tarea (\(T\)) | Labor que el sistema debe ejecutar | Resolver los problemas del examen de economía |
| Experiencia (\(E\)) | Los datos históricos que el sistema utiliza para entrenarse | Los exámenes anteriores con respuestas |
| Rendimiento (\(P\)) | La métrica cuantitativa que define el éxito | La calificación obtenida en el examen |
Con estos tres elementos ya pueden identificarlos en situaciones que no vienen resueltas de antemano.
Aquí hay seis situaciones reales. Para cada una, en equipo, decidan tres cosas y anótenlas:
- ¿Qué es la Tarea (\(T\)), la Experiencia (\(E\)) y el Rendimiento (\(P\))?
- ¿Hay respuestas correctas históricas disponibles, o no?
- ¿La respuesta que queremos es un número o una categoría?
| # | Situación |
|---|---|
| 1 | Una inmobiliaria quiere estimar el precio de venta de una casa antes de listarla. Tiene el historial de 8,000 ventas con características de cada propiedad y el precio al que se cerró. |
| 2 | Un banco quiere detectar transacciones fraudulentas. Tiene millones de transacciones históricas, y su equipo antifraude marcó cuáles resultaron ser fraude. |
| 3 | Una tienda departamental quiere entender qué tipos de cliente tiene para diseñar campañas distintas. Tiene tres años de compras, pero nunca ha clasificado a nadie. |
| 4 | Una empresa quiere estimar en cuántos días entregará un proveedor su próximo pedido. Tiene tres años de entregas con la fecha prometida y la fecha real. |
| 5 | Un call center tiene presupuesto para llamar a 500 de sus 50,000 clientes y ofrecerles un producto. Tiene el registro de quién aceptó y quién no en campañas anteriores. |
| 6 | Una planta quiere anticipar la falla de una máquina. Tiene dos años de lecturas de sensores, pero la máquina nunca ha fallado en ese periodo. |
Una de las seis no tiene una sola respuesta correcta. ¿Cuál, y de qué depende?
| # | Tarea (\(T\)) | Experiencia (\(E\)) | Rendimiento (\(P\)) | ¿Respuesta histórica? | ¿Número o categoría? |
|---|---|---|---|---|---|
| 1 | Predecir el precio de venta de una propiedad | 8,000 ventas con características y precio de cierre | Error entre precio predicho y precio real | Sí — el precio de cierre | Número → Regresión |
| 2 | Clasificar una transacción como fraudulenta o legítima | Millones de transacciones con la etiqueta que puso el equipo antifraude | Precisión / Recall al detectar fraude | Sí — la etiqueta fraude / no fraude | Categoría → Clasificación |
| 3 | Agrupar clientes en segmentos con comportamiento similar | Tres años de compras, sin ninguna etiqueta de “tipo de cliente” | Qué tan compactos y separables quedan los grupos | No — nadie ha dicho cuál es el “tipo” correcto | Categoría, pero inventada por el algoritmo → Clusterización |
| 4 | Predecir en cuántos días llegará el próximo pedido | Tres años de entregas con fecha prometida y fecha real | Error entre días predichos y días reales | Sí — la fecha real de entrega | Número → Regresión |
| 5 | Decidir a cuáles 500 de 50,000 clientes llamar | Resultado (aceptó / no aceptó) de campañas anteriores | Conversiones logradas con las 500 llamadas | Sí — quién aceptó en el pasado | Categoría en teoría — ver nota abajo |
| 6 | Anticipar que una máquina va a fallar | Dos años de lecturas de sensores sin ninguna falla registrada | Qué tan bien distingue comportamiento anómalo del normal | No — no hay ni una sola falla etiquetada | No aplica → Detección de anomalías |
Una nota al margen sobre el caso 2. Su respuesta es inequívoca porque alguien ya hizo un trabajo: el equipo antifraude revisó transacción por transacción y marcó las fraudulentas. Vale la pena imaginar el mismo banco sin ese trabajo hecho. El problema de negocio sería idéntico —detectar fraude— pero no habría nada que aprender del mapeo transacción → fraude, y lo único posible sería detección de anomalías no supervisada: el sistema no sabría qué es un ataque, pero sí que este comportamiento es rarísimo comparado con el tráfico normal. Mismo problema de negocio, dos problemas de Machine Learning distintos, y lo que decide cuál es que alguien haya etiquetado o no.
El caso 5 revela algo más fino. Formalmente es clasificación binaria: ¿acepta o no acepta? Pero fíjense en la restricción real: solo puedes llamar a 500 de 50,000. No necesitas saber quién aceptará; necesitas ordenar a los 50,000 y llamar a los primeros 500. Eso no lo resuelve una etiqueta, lo resuelve una probabilidad bien construida. Volveremos a este punto más adelante, con la regresión logística.
La conclusión de fondo. El paradigma no lo determina el problema de negocio, lo determina la Experiencia disponible (\(E\)). Antes de preguntar “¿qué algoritmo uso?”, la pregunta es “¿qué respuestas correctas tengo, y quién las produjo?”.
Implicación Estratégica
La definición revela algo poderoso: el Machine Learning es un activo que se aprecia con el uso. A diferencia del software tradicional que se deprecia si no se actualiza, un sistema de ML teóricamente se vuelve más inteligente y valioso a medida que la organización acumula más experiencia (\(E\)).
La Analogía del Jardinero vs. el Arquitecto
Una metáfora poderosa para entender este cambio de rol:
| Arquitecto (Programación Tradicional) | Jardinero (Machine Learning) |
|---|---|
| Diseña cada detalle desde arriba hacia abajo | Prepara el entorno adecuado |
| Si la estructura falla, es error de diseño | Nutre el suelo (datos limpios) |
| Control absoluto, adaptabilidad baja | La planta crece por procesos intrínsecos |
| El éxito depende de prever cada contingencia | El éxito depende de cultivar el ecosistema |
Como ingenieros de negocios, nuestro objetivo es convertirnos en “Jardineros de Datos” competentes, capaces de cultivar modelos que resuelvan problemas complejos dentro del marco CRISP-DM.
Fundamentos Teóricos: La Aproximación de Funciones
La Hipótesis de la Función Universal
Suponemos que existe una función \(f\) :
\[y = f(x)\]
Donde:
- \(x\) es el vector de variables de entrada (precio, día de la semana, clima, competidores)
- \(y\) es la variable objetivo que queremos predecir (demanda, ventas, probabilidad de compra)
Si conociéramos \(f(x)\) a la perfección, no necesitaríamos Machine Learning; simplemente usaríamos la fórmula para tomar decisiones perfectas.
Sin embargo, en la realidad:
- \(f(x)\) es incognoscible: Es infinitamente compleja, dinámica y a menudo oculta en la psicología humana o las interacciones caóticas del mercado
- El mundo es ruidoso: Existen factores aleatorios imposibles de medir
Por lo tanto, la realidad se expresa como:
\[y = f(x) + \epsilon\]
Donde:
- \(\epsilon\) (épsilon) sulee representar el error irreducible o ruido aleatorio. Sin embargo, también puede representar el efecto de variables que no hemos medido.
El Objetivo: Encontrar la Función Estimada
El objetivo del Machine Learning es utilizar datos históricos para construir una función estimada, denotada como \(\hat{f}(x)\), que imite a \(f(x)\) lo suficientemente bien como para ser útil:
\[y \approx \hat{f}(x)\]
Este proceso es análogo a la Ingeniería Inversa: observamos las entradas y salidas de la “caja negra” de la realidad y tratamos de construir una “caja blanca” matemática que produzca las mismas salidas ante las mismas entradas.
Generalización vs. Memorización
Tienen doce meses de datos de una campaña: cuánto se gastó en marketing y cuántos ingresos entraron. Tres analistas proponen tres modelos distintos.
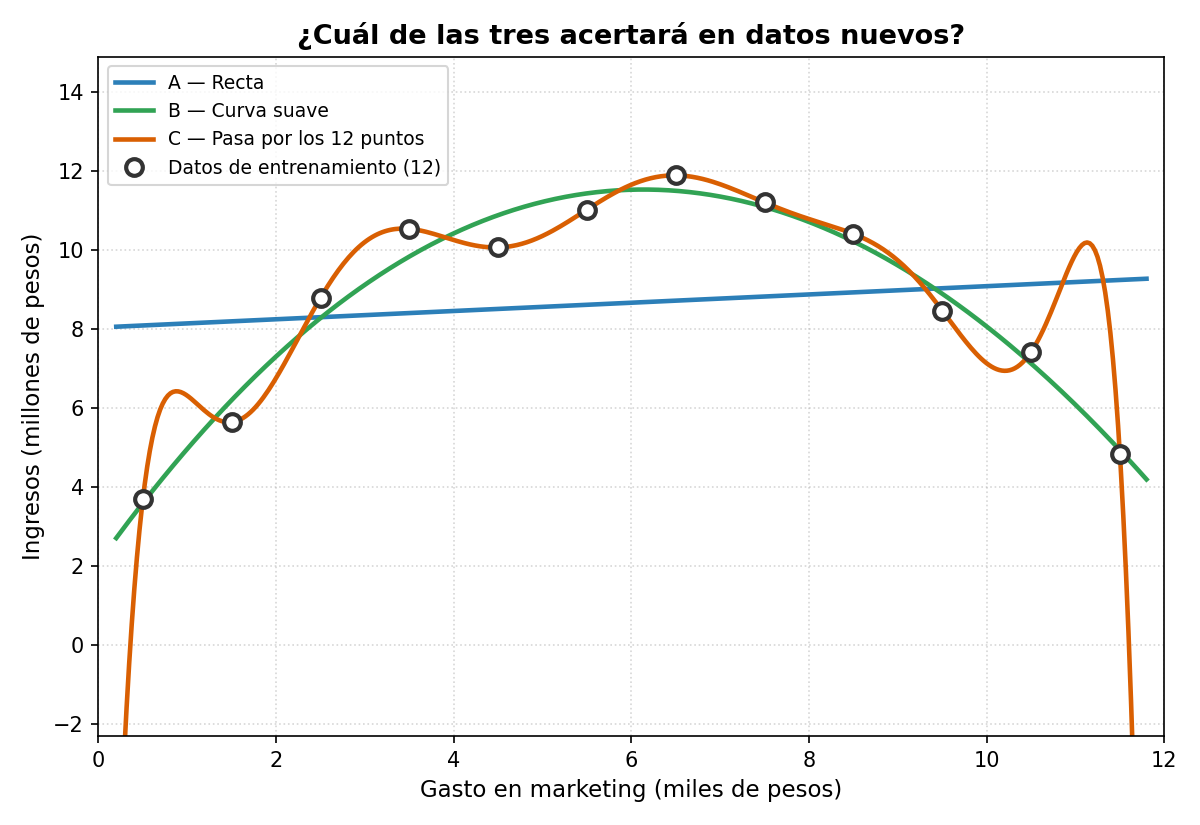
Voten a mano alzada: ¿cuál de las tres predecirá mejor los ingresos del próximo mes, uno que todavía no está en la gráfica? A, B o C.
Ahora discutan dos minutos con la persona de al lado. Quien cambió de opinión, explique por qué. Voten otra vez.
Dos observaciones antes de ver la respuesta. La curva C no se equivoca en ni un solo punto de los doce: ¿por qué alguien votaría por otra? Y la recta A se equivoca en casi todos: ¿por qué alguien votaría por ella?
Estos son los seis meses siguientes, que ninguno de los tres modelos vio al ajustarse:
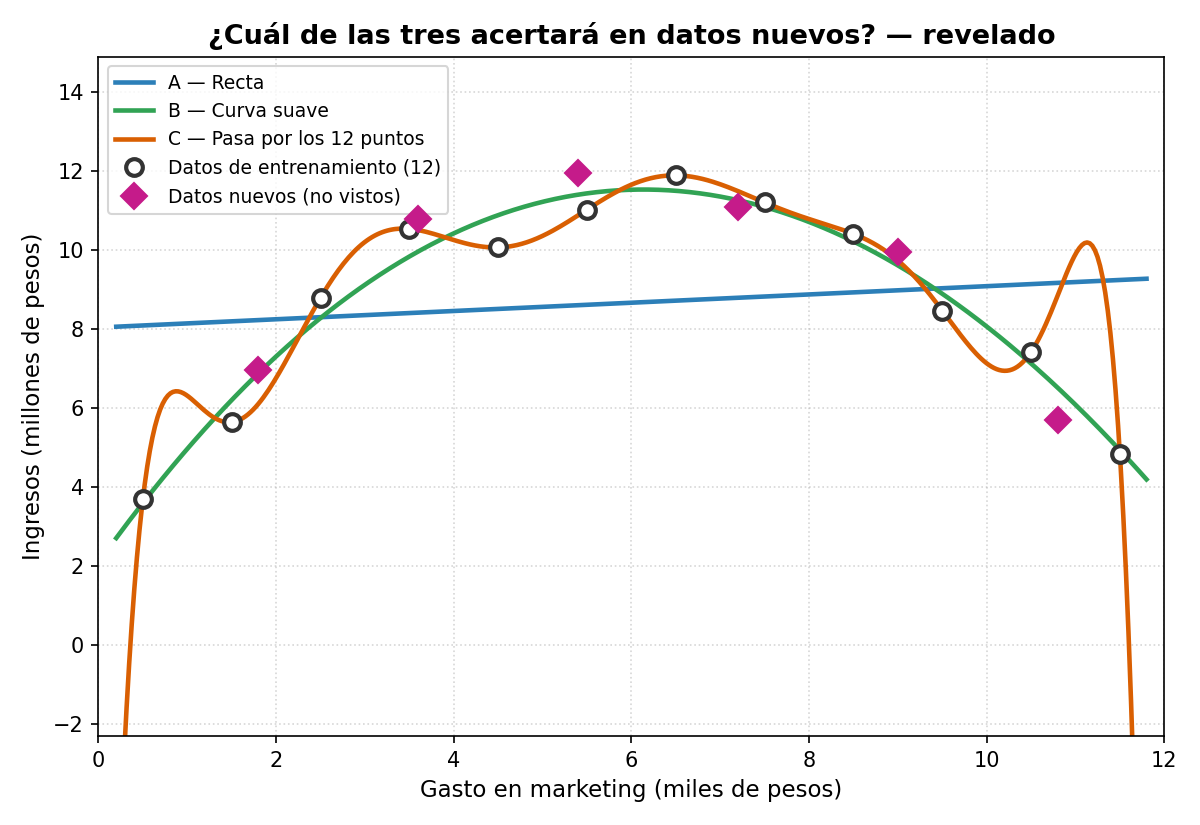
| Modelo | Error cuadrático medio en datos nuevos |
|---|---|
| A — Recta | 6.10 |
| B — Curva suave | 0.29 |
| C — Pasa por los 12 puntos | 2.01 |
Gana la de en medio, y las dos extremas pierden por goliza. Ese es el resultado importante, y conviene ver que pierden por razones opuestas:
- La recta A ni siquiera podía capturar la forma de los datos. Se equivoca en el histórico y se equivoca en los datos nuevos, por la misma razón las dos veces: es demasiado simple para el fenómeno. Su error no viene de los datos, viene de la decisión de usar una recta.
- La curva C capturaba el histórico a la perfección —error cero en los doce puntos— y aun así falla siete veces más que B en datos nuevos. Su problema es el contrario: es tan flexible que se dedicó a seguir el zigzag accidental de estos doce meses en particular. En el tramo final llega a predecir ingresos negativos, algo que ningún dato sugería.
Fíjense en lo que esto significa para su intuición: el error en los datos que ya tienen no les dice cuál modelo es mejor. C ganaba 12 a 0 en el histórico y perdió en lo único que importa.
Las dos formas de perder tienen nombre, y la tensión entre ellas es el compromiso que gobierna todos los modelos de este curso.
La distinción clave es que no queremos simplemente “memorizar” los puntos de datos pasados. Queremos aprender la estructura subyacente de \(f(x)\) para poder predecir \(y\) para nuevos valores de \(x\) que nunca hemos visto antes.
Esta capacidad de aplicar lo aprendido a escenarios futuros no vistos se llama Generalización.
Analogía Educativa:
- Memorización: Un estudiante memoriza las respuestas de un examen de práctica → Obtiene 100% en la práctica pero falla en el examen real
- Generalización: El estudiante aprende los principios subyacentes → Obtiene 90% en la práctica y mantiene ese 90% en el examen real
El ML busca aprender los principios, no memorizar los datos.
Paradigmas de Aprendizaje: Supervisado y No Supervisado
Dependiendo de la naturaleza de la “Experiencia” (\(E\)) disponible, los algoritmos de ML se dividen en paradigmas distintos.
Aprendizaje Supervisado: Aprendiendo con un Maestro
El aprendizaje supervisado es el paradigma dominante en las aplicaciones de negocios actuales. Se caracteriza por el uso de Datos Etiquetados.
El Proceso
Imagina un estudiante (el algoritmo) y un maestro (los datos históricos):
- El maestro muestra al estudiante una serie de ejemplos (inputs \(x\)) junto con las respuestas correctas (targets \(y\))
- El estudiante hace una predicción
- El maestro la corrige
- El estudiante ajusta su comprensión interna para reducir el error en el futuro
La Meta
Aprender el mapeo \(x \rightarrow y\) para poder predecir \(y\) cuando solo veamos \(x\) en el futuro.
Subtipos Principales
1. Regresión: La variable de salida \(y\) es numérica/continua
- Ejemplos: Predecir ventas del próximo mes, estimar tiempo de vida de maquinaria, calcular precio óptimo de seguro
- Pregunta: “¿Cuánto?” o “¿Cuántos?”
2. Clasificación: La variable de salida \(y\) es categórica/discreta
- Ejemplos: ¿El cliente comprará? (Sí/No), ¿Es esta imagen un perro o un gato?, ¿Es esta transacción fraude?
- Pregunta: “¿Cuál?” o “¿Qué tipo?”
Ejemplo de Negocio: Predicción de Churn
Una empresa de telecomunicaciones quiere predecir la fuga de clientes (Churn):
- Datos históricos: 5 años de perfiles de clientes con columna “Canceló Servicio: Sí/No”
- Entrenamiento: El modelo aprende patrones de clientes que cancelaron vs. los que se quedaron
- Aplicación: Se aplica a clientes actuales para identificar quiénes están en riesgo de irse antes de que suceda
- Valor: Permite intervención proactiva con campañas de retención dirigidas
Aprendizaje No Supervisado: Descubrimiento de Patrones
El aprendizaje no supervisado opera en un entorno de mayor incertidumbre. No hay maestro ni respuestas correctas. Los datos consisten únicamente en entradas (\(x\)), sin ninguna etiqueta de salida (\(y\)).
El Proceso
El algoritmo explora los datos sin guía externa, buscando estructuras inherentes, similitudes o anomalías. Es comparable a un niño que organiza sus juguetes por forma o color sin que nadie le haya enseñado los nombres de las categorías.
La Meta
Descubrir información oculta (“insights”) sobre la estructura de los datos que la empresa desconocía.
Aplicaciones Principales en Negocios
1. Clusterización (Clustering): Agrupar instancias similares
- Ejemplo: Segmentación de clientes. El algoritmo descubre que existen tres tipos de compradores: “Cazadores de ofertas”, “Compradores impulsivos de fin de semana” y “Clientes corporativos”, basándose solo en patrones de compra
2. Detección de Anomalías: Identificar eventos que se desvían significativamente de la norma
- Ejemplo: Seguridad informática. El sistema no sabe qué es un “ataque”, pero detecta que este comportamiento específico es extremadamente raro comparado con el tráfico normal
3. Reducción de Dimensionalidad: Simplificar datos complejos con muchas variables a un número menor de variables representativas
Tabla Comparativa
| Característica | Aprendizaje Supervisado | Aprendizaje No Supervisado |
|---|---|---|
| Datos de Entrada | Datos Etiquetados (\(x, y\)) | Datos No Etiquetados (\(x\)) |
| Objetivo | Predicción (Predecir \(y\)) | Descripción (Entender estructura de \(x\)) |
| Feedback | Directo (Error entre predicción y real) | Inexistente (Basado en coherencia interna) |
| Complejidad de Evaluación | Más fácil de evaluar (¿Acertó?) | Difícil de evaluar objetivamente |
| Ejemplo Típico | Predecir precio de acciones | Segmentar clientes por comportamiento |
| Fase CRISP-DM típica | Modelado con objetivo claro | Entendimiento de Datos / Exploración |
El Dilema Estratégico: Sesgo vs. Varianza
Antes de implementar cualquier modelo en CRISP-DM, el ingeniero de negocios debe comprender el compromiso fundamental que gobierna la calidad de todos los modelos de ML: el Trade-off Sesgo-Varianza.
Este concepto conecta la teoría matemática con la estrategia de gestión de riesgos.
La Descomposición del Error
El error total de cualquier modelo predictivo se puede descomponer en tres partes:
\[\text{Error Total} = \text{Sesgo}^2 + \text{Varianza} + \text{Error Irreducible } (\epsilon)\]
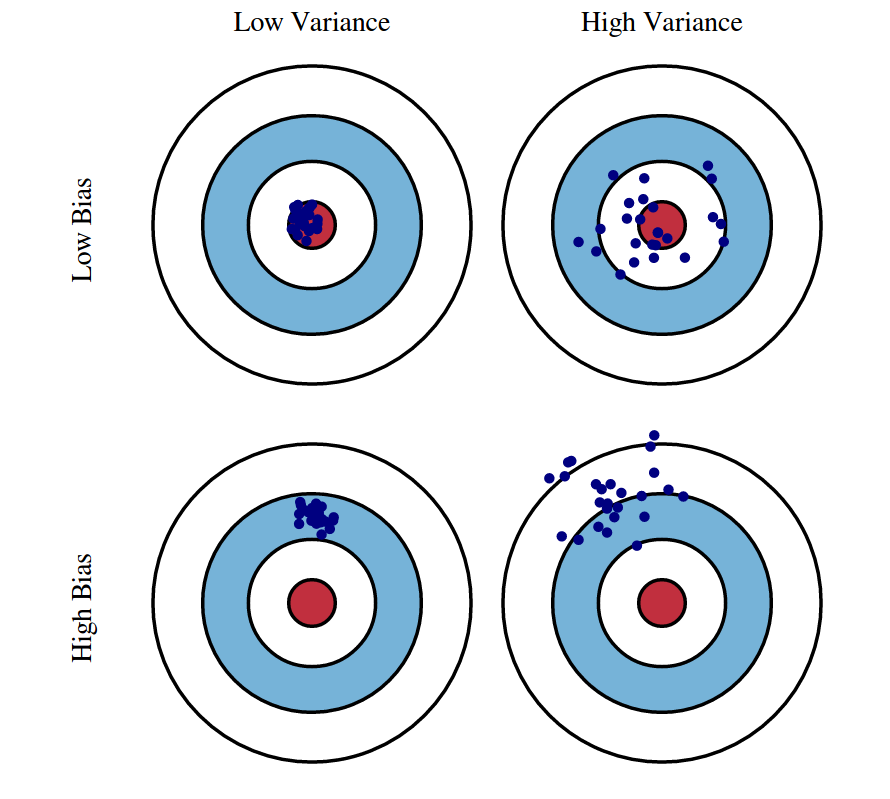
El Sesgo (Bias): El Error de la Simplificación
El sesgo ocurre cuando el modelo hace suposiciones demasiado simplistas sobre la función subyacente \(f(x)\) para facilitar el aprendizaje.
Concepto: Un modelo con alto sesgo es “cerrado de mente”. Ignora la complejidad de los datos y fuerza una solución simple.
- Síntoma (Underfitting/Subajuste): El modelo tiene un rendimiento pobre tanto en datos de entrenamiento como en datos de prueba. No ha aprendido la relación real
La Varianza (Variance): El Error de la Complejidad
La varianza es la sensibilidad del modelo a las fluctuaciones aleatorias (ruido) en los datos de entrenamiento.
Concepto: Un modelo con alta varianza es “impresionable”. Presta tanta atención a los detalles de los datos históricos que termina memorizando el ruido (\(\epsilon\)) en lugar de la señal (\(f(x)\)).
- Síntoma (Overfitting/Sobreajuste): El modelo tiene un rendimiento espectacular en datos de entrenamiento (quizás 99% de precisión) pero falla miserablemente en datos nuevos. No generaliza; solo recuerda
El mismo fenómeno, visto de otra forma
El Trade-off Sesgo-Varianza
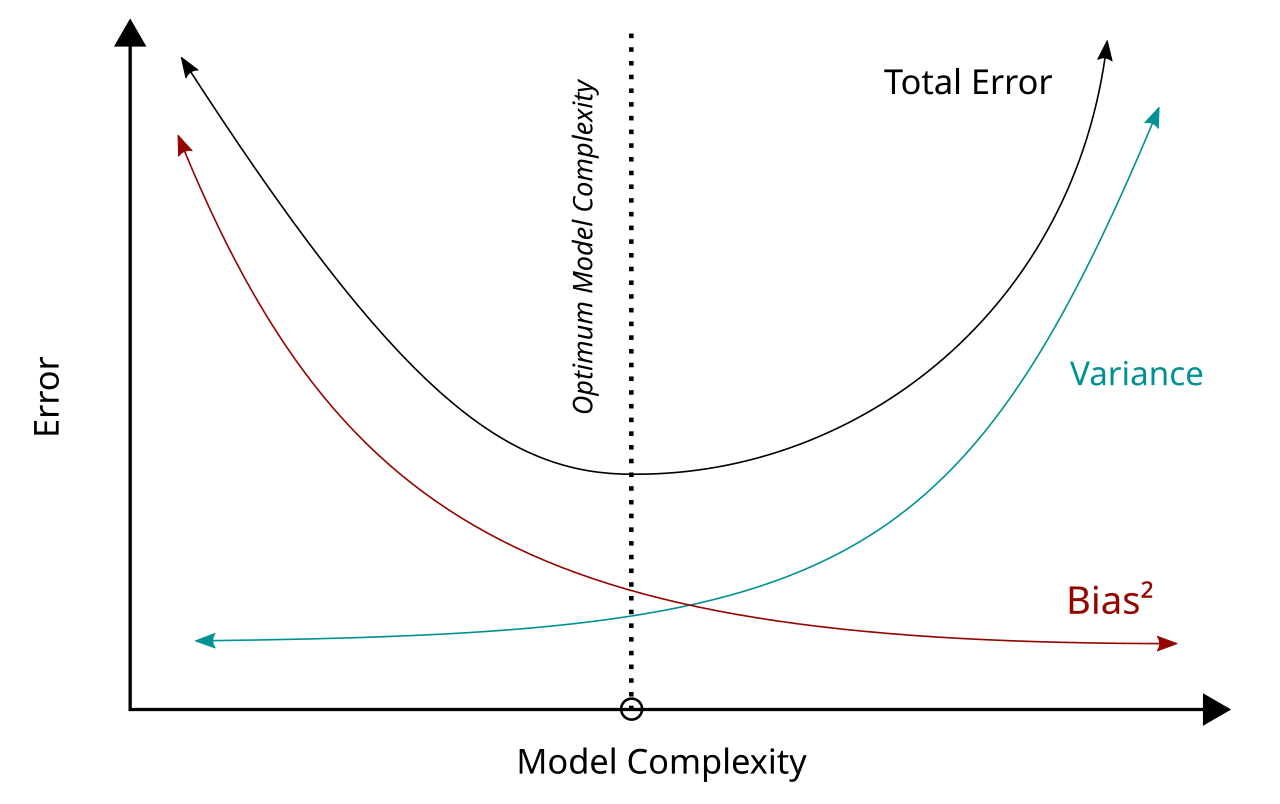
En el aprendizaje automático, existe una tensión inevitable:
- Modelo más complejo → Reduce sesgo (se ajusta mejor) pero aumenta varianza (más inestable)
- Modelo más simple → Reduce varianza (más estable) pero aumenta sesgo (demasiado simple)
El objetivo es encontrar el punto óptimo donde la suma del sesgo y la varianza es mínima.
Esto se logra mediante técnicas como:
- Validación Cruzada: Evaluar el modelo en múltiples particiones de datos
- Regularización: Penalizar la complejidad innecesaria
- Early Stopping: Detener el entrenamiento antes del sobreajuste
Regresión Lineal: La Herramienta de Predicción Continua
La Regresión Lineal es el “caballo de batalla” de la analítica de negocios. Aunque existen algoritmos más modernos y complejos, la regresión lineal sigue siendo omnipresente debido a su simplicidad, velocidad y, sobre todo, interpretabilidad.
El Problema de Negocio
Se utiliza cuando la variable objetivo (\(y\)) es un número continuo:
- Proyección de ventas trimestrales ($)
- Estimación de la elasticidad-precio de la demanda
- Predicción del tiempo de entrega de un proveedor (días)
- Valoración de propiedades inmobiliarias
Intuición Geométrica
Imagina un gráfico de dispersión donde:
- Eje X: Gasto en Marketing
- Eje Y: Ingresos
Los puntos están dispersos pero muestran una tendencia ascendente. La regresión lineal intenta dibujar la línea recta que pasa “más cerca” de todos los puntos simultáneamente.
La Ecuación del Modelo
\[y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + ... + \beta_n x_n + \epsilon\]
Donde:
- \(\beta_0\) (Intercepto): Valor esperado de \(y\) cuando todas las \(x\) son cero (e.g., ventas base sin marketing)
- \(\beta_i\) (Coeficientes): Representan el peso o importancia de cada variable
- \(\epsilon\): Error residual
El Método de Mínimos Cuadrados (OLS)
¿Cómo decide la máquina cuál es la “mejor” línea?
Utiliza una función de costo llamada Suma de los Errores Cuadrados (SSE):
- Mide la distancia vertical (residuo) entre cada punto real y la línea propuesta
- Eleva estas distancias al cuadrado (para penalizar mucho más los errores grandes y eliminar signos negativos)
- Las suma todas
\[\text{Minimizar: } \sum_{i=1}^{n} (y_{\text{real}}^{(i)} - y_{\text{predicho}}^{(i)})^2\]
La línea que produce la suma más baja posible es la solución óptima.
Descenso en Gradiente: Cómo Encuentra la Máquina ese Mínimo
Mínimos Cuadrados nos dice qué minimizar. No nos dice cómo hacerlo. Esa segunda pregunta parece un detalle técnico y no lo es: es el motor que mueve a casi todos los modelos que veremos en el resto del curso.
Una empresa quiere un modelo mínimo: los ingresos son proporcionales al gasto en marketing, sin nada más.
\[\text{Ingresos} = \beta \times \text{Gasto en marketing}\]
Un solo número desconocido, \(\beta\). Estos son cuatro meses de datos (en millones de pesos):
| Mes | Gasto en marketing | Ingresos |
|---|---|---|
| 1 | 2.0 | 7.1 |
| 2 | 4.0 | 12.4 |
| 3 | 6.0 | 19.8 |
| 4 | 8.0 | 25.1 |
Un becario probó cinco valores de \(\beta\) y calculó, para cada uno, el error cuadrático medio sobre los cuatro meses:
| \(\beta\) propuesto | Error |
|---|---|
| 1.0 | 144.9 |
| 2.0 | 43.2 |
| 3.0 | 1.5 |
| 4.0 | 19.8 |
| 5.0 | 98.1 |
Tres preguntas, en equipos:
- ¿Cuál es el mejor \(\beta\) de la tabla? Ahora encuéntrenlo con dos decimales. ¿Cuántas evaluaciones más le piden al becario?
- El modelo de verdad de esa empresa no tiene 1 coeficiente: tiene 300. Y cada evaluación del error tarda 20 minutos. Con su método del punto anterior, ¿cuántas evaluaciones hacen falta? ¿Cuánto tiempo es eso?
- Vuelvan a mirar la tabla de cinco renglones. Cada evaluación les entregó un número: la altura del error. ¿Qué otra información estaba disponible en esos mismos cálculos y no usaron?
Pregunta 1: el mejor de la tabla es \(\beta = 3\), y no es el óptimo. El verdadero mínimo está en \(\beta = 3.195\), con un error de 0.31 en lugar de 1.5. Para encontrarlo por prueba y error con dos decimales, barriendo el rango de 0 a 10 de centésima en centésima, hacen falta 1,000 evaluaciones. Con cuatro filas de datos eso es instantáneo, así que hasta aquí el método parece razonable.
Pregunta 2: aquí se acaba el método. Con 300 coeficientes hay que probar combinaciones, no valores sueltos. Aun siendo generosos y probando solo diez valores por coeficiente, las combinaciones son:
\[10^{300}\]
El universo observable tiene alrededor de \(10^{80}\) átomos. No es que tarde mucho: es que no se puede, con ninguna computadora, hoy ni nunca. Y 300 variables es un modelo modesto —cualquier modelo de crédito serio tiene más.
El problema no es la lentitud de la máquina. Es que la búsqueda a ciegas crece exponencialmente con el número de coeficientes, y todo lo interesante en Machine Learning vive en dimensiones altas.
Pregunta 3: tiraron a la basura la pendiente. Cada vez que evaluaron el error obtuvieron la altura de la curva en ese punto, y descartaron un dato que estaba ahí mismo: en qué dirección y qué tan rápido bajaba el error. Entre \(\beta=1\) y \(\beta=2\) el error cayó 101.7 unidades; entre \(\beta=4\) y \(\beta=5\) subió 78.3. Esa información dice, sin adivinar, hacia qué lado hay que moverse.
Y aquí está lo que salva el problema de las 300 dimensiones: esa pendiente se puede calcular con una fórmula —la derivada— para los 300 coeficientes a la vez, con una sola pasada por los datos. El costo deja de ser exponencial en el número de variables y se vuelve lineal.
Si alguien en su equipo dijo “empiecen donde sea, vean para qué lado baja, den un paso en esa dirección y repitan”, acaban de inventar el Descenso en Gradiente, el algoritmo que entrena hoy desde una regresión lineal hasta un modelo de lenguaje.
La intuición: bajar la montaña con niebla
Están parados en la ladera de un valle, de noche y con niebla espesa. No ven el fondo, no ven a diez metros. Pero sí pueden sentir, con los pies, hacia qué lado baja el terreno justo donde están parados.
La estrategia es obvia: dar un paso hacia donde baja, volver a sentir la inclinación, dar otro paso. Repetir hasta que el suelo se sienta plano: ahí está el fondo.
Traducido al problema:
| En la montaña | En el modelo |
|---|---|
| Su posición | Los valores actuales de los coeficientes \(\beta\) |
| La altura del terreno | El error \(J(\beta)\) que produce ese modelo |
| La inclinación bajo sus pies | El gradiente: la derivada del error respecto a cada coeficiente |
| El tamaño de su paso | La tasa de aprendizaje \(\alpha\) |
| El fondo del valle | Los coeficientes que minimizan el error |
Nadie necesita ver el mapa completo. Basta con información local: la pendiente en el punto donde uno está.
La regla de actualización
Formalmente, el algoritmo repite un solo renglón:
\[\beta_j \leftarrow \beta_j - \alpha \frac{\partial J}{\partial \beta_j}\]
Léanlo por partes:
- \(\dfrac{\partial J}{\partial \beta_j}\) es la pendiente del error en la dirección del coeficiente \(j\). Si es positiva, aumentar \(\beta_j\) empeora el error.
- El signo menos es todo el algoritmo: si la pendiente es positiva, el coeficiente baja; si es negativa, sube. Siempre en contra de la pendiente, siempre cuesta abajo.
- \(\alpha\) decide qué tan largo es el paso.
Al vector de todas las derivadas parciales, \(\nabla J = \left(\frac{\partial J}{\partial \beta_0}, \dots, \frac{\partial J}{\partial \beta_p}\right)\), se le llama gradiente, y apunta en la dirección de máximo ascenso. Moverse en \(-\nabla J\) es bajar por la ruta más empinada disponible.
El gradiente de la regresión lineal
Escribamos el error como promedio (dividir entre \(n\) no cambia dónde está el mínimo, solo la escala del paso):
\[J(\beta) = \frac{1}{n}\sum_{i=1}^{n} \left(y^{(i)} - \hat{y}^{(i)}\right)^2 \qquad \text{con} \qquad \hat{y}^{(i)} = \beta_0 + \beta_1 x_1^{(i)} + \dots + \beta_p x_p^{(i)}\]
Derivando respecto a un coeficiente cualquiera:
\[\frac{\partial J}{\partial \beta_j} = -\frac{2}{n}\sum_{i=1}^{n} \underbrace{\left(y^{(i)} - \hat{y}^{(i)}\right)}_{\text{residuo } r^{(i)}} \; x_j^{(i)}\]
La regla completa para la regresión lineal queda:
\[\beta_j \leftarrow \beta_j + \frac{2\alpha}{n}\sum_{i=1}^{n} r^{(i)} x_j^{(i)}\]
Esa fórmula tiene una lectura de negocio muy concreta. El término \(\sum r^{(i)} x_j^{(i)}\) mide si lo que el modelo todavía se está equivocando sigue moviéndose junto con la variable \(j\):
- Si los meses en que el modelo se queda corto (\(r > 0\)) son justamente los de mucho gasto en televisión, esa suma es positiva y el coeficiente de televisión sube: el error todavía tenía televisión adentro.
- Si ya no hay ninguna relación entre el error restante y la variable, la suma es cero y ese coeficiente deja de moverse.
Por eso el algoritmo se detiene donde se detiene: en el punto en que no queda rastro de ninguna variable dentro del error. Ese es exactamente el mismo punto que encuentra Mínimos Cuadrados, ahora alcanzado paso a paso en lugar de resuelto de un golpe.
El ejemplo, paso a paso
Volvamos a los cuatro meses de la dinámica, arrancando en un \(\beta_0 = 1\) elegido arbitrariamente, con \(\alpha = 0.01\):
| Paso | \(\beta\) actual | Error | Gradiente | \(\beta\) siguiente |
|---|---|---|---|---|
| 0 | 1.000 | 144.86 | −131.70 | 2.317 |
| 1 | 2.317 | 23.44 | −52.68 | 2.844 |
| 2 | 2.844 | 4.01 | −21.07 | 3.055 |
| 3 | 3.055 | 0.91 | −8.43 | 3.139 |
| 4 | 3.139 | 0.41 | −3.37 | 3.173 |
| 5 | 3.173 | 0.33 | −1.35 | 3.186 |
| 6 | 3.186 | 0.32 | −0.54 | 3.191 |
| 7 | 3.191 | 0.31 | −0.22 | 3.194 |
| 8 | 3.194 | 0.31 | −0.09 | 3.194 |
En nueve pasos llegó a 3.194, contra el óptimo exacto de 3.195. El becario habría necesitado mil evaluaciones para lo mismo.
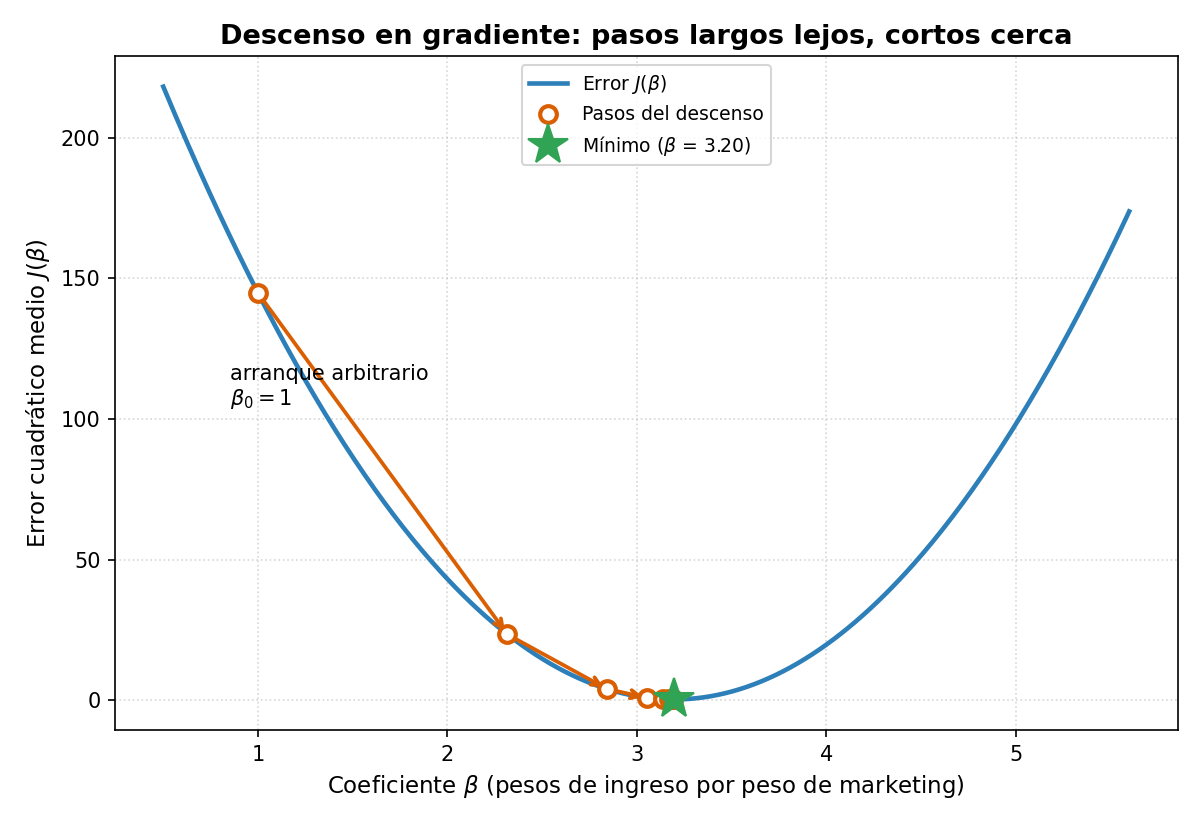
Fíjense en la columna del gradiente: −131.70, −52.68, −21.07, −8.43… El algoritmo frena solo. Lejos del mínimo la pendiente es pronunciada y los pasos son largos; cerca del fondo la pendiente se aplana y los pasos se acortan sin que nadie lo programe. Esa es la razón por la que no se pasa de largo y por la que “detenerse” tiene un significado natural: cuando el gradiente es casi cero, el modelo ya no tiene nada que aprender de estos datos.
La tasa de aprendizaje \(\alpha\): el único parámetro que hay que elegir
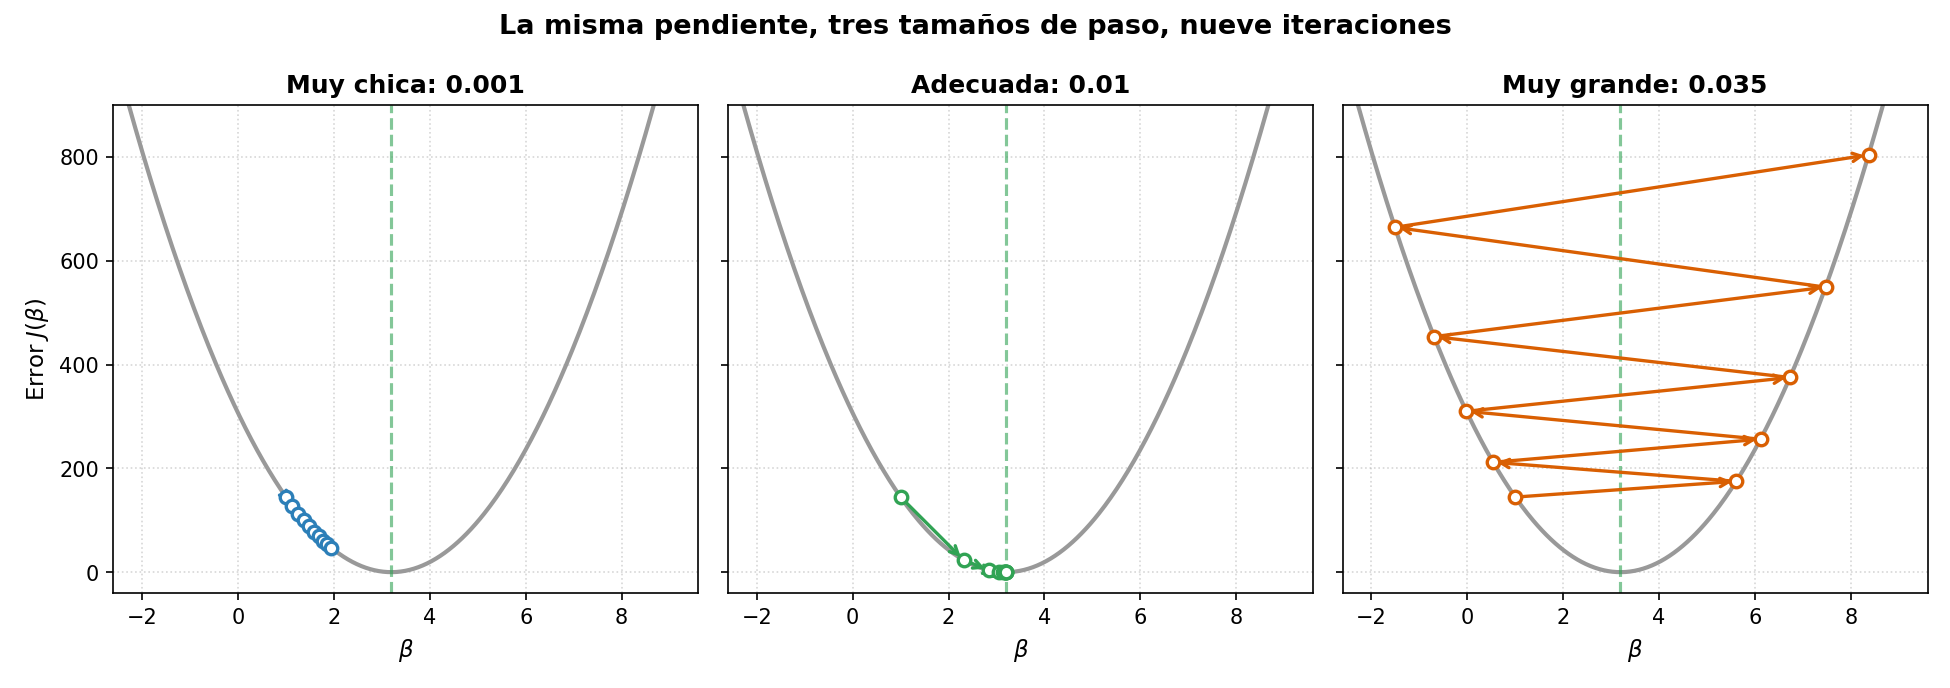
El tamaño del paso no viene de los datos: lo elige quien entrena el modelo. Es el ejemplo más limpio de un hiperparámetro.
| \(\alpha\) | Qué pasa | Síntoma |
|---|---|---|
| Muy chica (0.001) | Avanza en la dirección correcta, pero a paso de tortuga: tras nueve iteraciones va en \(\beta = 1.94\) y el mínimo está en 3.195 | El entrenamiento es carísimo y parece que “no aprende” |
| Adecuada (0.01) | Llega al mínimo en unas cuantas iteraciones y se queda ahí | El error baja rápido y luego se aplana |
| Muy grande (0.035) | Se pasa del mínimo, cae más arriba del otro lado, se vuelve a pasar con más fuerza; tras nueve pasos está en \(\beta = 8.37\), mucho más lejos que donde empezó | El error crece en cada iteración, o aparecen NaN |
La regla práctica es simple: si el error sube o explota, la tasa es demasiado grande; si baja pero desesperadamente lento, es demasiado chica. En la práctica se prueba una escala logarítmica (0.0001, 0.001, 0.01, 0.1) y se grafica el error contra la iteración —esa gráfica se llama curva de aprendizaje y es lo primero que se revisa cuando un entrenamiento sale mal.
Por qué hay que estandarizar las variables
Hay una condición que casi nadie menciona la primera vez y que hace fracasar más entrenamientos que ninguna otra cosa: el descenso en gradiente da un paso del mismo tamaño en todas las direcciones.
Supongan dos variables: antigüedad del cliente (de 1 a 10 años) e ingreso (de 20 a 100 mil pesos). Un cambio de “una unidad” significa un año en una y un peso en la otra, cosas que no se parecen en nada. El resultado es que la superficie de error deja de ser un tazón redondo y se convierte en un cañón largo y angosto.
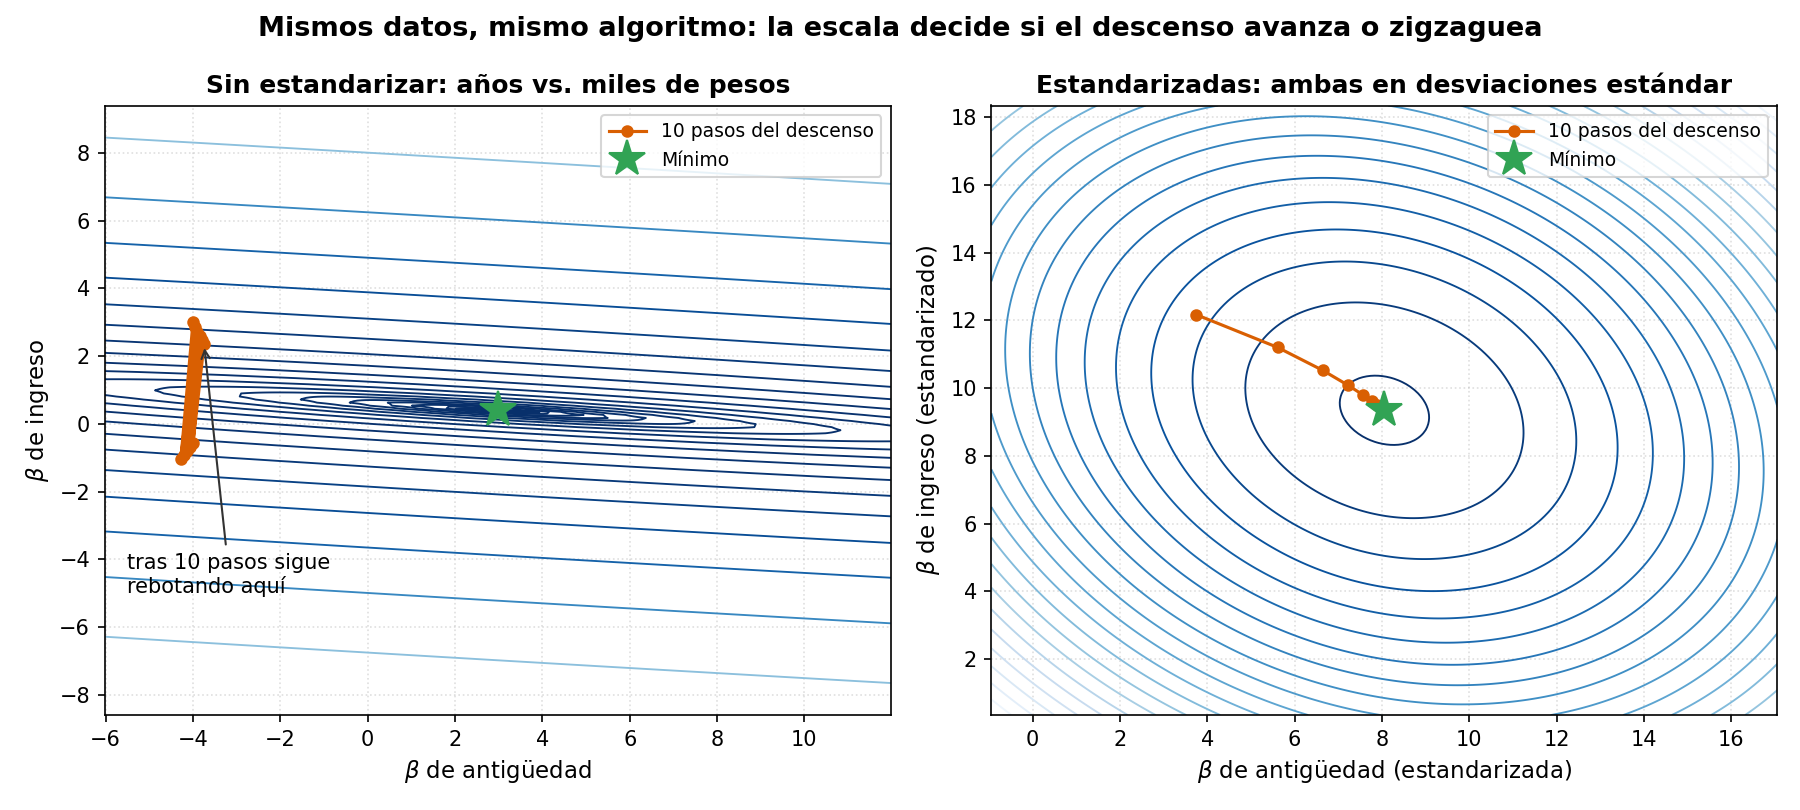
En el panel izquierdo el paso que sirve para una dirección es un desastre para la otra: el algoritmo rebota de pared a pared del cañón y casi no avanza hacia el fondo. En el panel derecho, con las dos variables convertidas a desviaciones estándar, las curvas de nivel son casi circulares y el descenso camina en línea recta hacia el mínimo.
Es el mismo cuidado que exigirá K-Means más adelante en el capítulo, y por una razón emparentada: cuando un algoritmo mide distancias o pasos, las unidades de las variables se vuelven parte del algoritmo.
Este problema es exclusivo del método iterativo. Mínimos Cuadrados resuelto en forma exacta da el mismo resultado con o sin estandarizar, porque no “camina” hacia ningún lado. Si su modelo entrena con descenso en gradiente —redes neuronales, SGDRegressor, regresión logística en muchas implementaciones— estandarizar no es opcional.
La curva de error de la regresión lineal es un tazón: tiene un solo mínimo, y no importa dónde se arranque, el descenso llega al mismo lugar. A esa propiedad se le llama convexidad.
Las redes neuronales no son convexas: su superficie de error tiene valles múltiples, y dónde se termine depende de dónde se arrancó. Esa es la razón por la que entrenar una red dos veces con los mismos datos puede dar dos modelos distintos, y por la que la inicialización de los pesos es un tema de investigación. En regresión lineal, ese problema simplemente no existe.
Volver a la definición: aprender es optimizar
Al principio del capítulo definimos el aprendizaje de máquina con una frase que sonaba bien pero no decía cómo: “su desempeño en la tarea \(T\), medido por \(P\), mejora con la experiencia \(E\)”. Esa frase acaba de convertirse en un algoritmo:
| En la definición | En el descenso en gradiente |
|---|---|
| Tarea (\(T\)) | La forma del modelo: \(\hat{y} = \beta_0 + \beta_1x_1 + \dots\) |
| Experiencia (\(E\)) | Los datos que entran en el gradiente: cada residuo multiplicado por cada variable |
| Rendimiento (\(P\)) | La función de costo \(J(\beta)\) |
| “mejora con \(E\)” | \(\beta_j \leftarrow \beta_j - \alpha \frac{\partial J}{\partial \beta_j}\), repetido hasta que la pendiente se aplana |
Para una máquina, aprender es mover parámetros para bajar un número. No hay nada más. Y eso significa que armar un modelo de Machine Learning es siempre elegir tres piezas:
- Una familia de funciones (¿entre qué candidatos buscamos?)
- Una función de costo (¿qué significa “equivocarse”?)
- Un optimizador (¿cómo recorremos la familia buscando el mínimo?)
Ese esqueleto no cambia en el resto del curso. Lo único que cambia es qué se pone en cada casilla:
| Modelo | Familia de funciones | Función de costo | Optimizador |
|---|---|---|---|
| Regresión lineal | Combinaciones lineales de las variables | Error cuadrático | Fórmula cerrada o descenso en gradiente |
| Ridge / Lasso | Las mismas combinaciones lineales | Error cuadrático + penalización | Descenso en gradiente |
| Regresión logística | Sigmoide de una combinación lineal | Entropía cruzada (log-verosimilitud) | Descenso en gradiente |
| Boosting (cap. 7) | Sumas de árboles | La que se elija | Descenso en gradiente, un árbol por paso |
| Redes neuronales (cap. 8) | Composiciones de capas | La que se elija | Descenso en gradiente + retropropagación |
Cuando en el capítulo 8 aparezca la frase “entrenar una red neuronal”, no habrá nada conceptualmente nuevo: la familia de funciones será enorme y el costo será otro, pero el ciclo será este mismo, el de la fórmula de una línea que acabamos de escribir.
Vale la pena notar dónde queda la elección humana en este esquema. El optimizador elige los coeficientes; nadie más. Pero la familia de funciones y la función de costo las elige una persona, y esas dos decisiones son las que determinan si el modelo sirve al negocio. El algoritmo minimiza con obediencia perfecta lo que le hayamos pedido minimizar.
Optimizar no es aprender
Y ahí está la trampa, que es la razón de fondo por la que vale la pena hacer esta conexión explícita.
El descenso en gradiente minimiza el error sobre los datos que ya tenemos. Lo que al negocio le importa es el error sobre datos que todavía no existen. Esos son dos números distintos, y el algoritmo solo puede ver el primero.
Ya vimos qué pasa cuando se confunden. En la votación de las tres curvas, la curva C pasaba exactamente por los doce puntos: error de entrenamiento cero, el mejor resultado de optimización posible, imposible de superar. Y perdió. Un optimizador perfecto habría entregado la curva C.
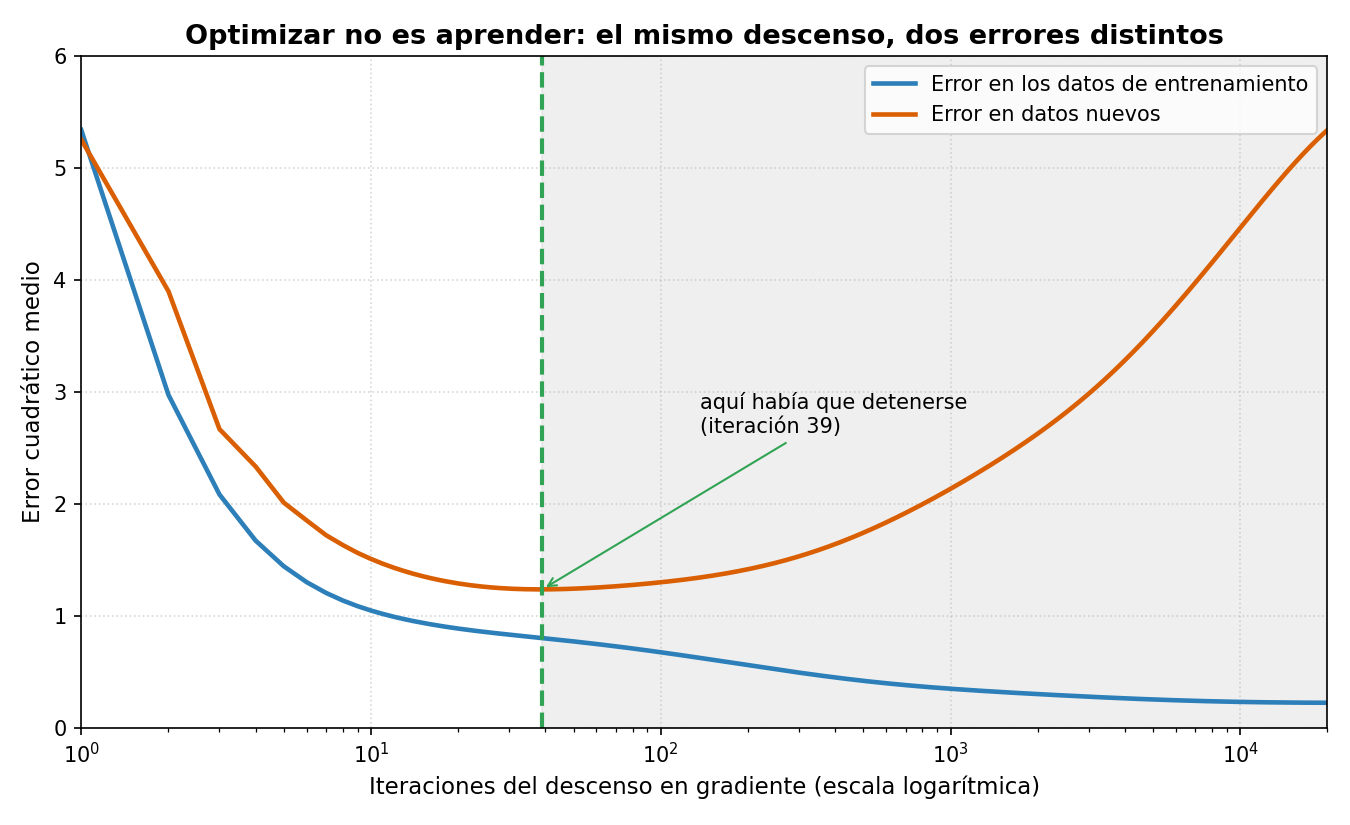
Lo mismo se puede ver ahora en el lenguaje de esta sección, con un solo modelo al que dejamos correr:
| Iteración | Error de entrenamiento | Error en datos nuevos |
|---|---|---|
| 1 | 5.34 | 5.25 |
| 10 | 1.05 | 1.51 |
| 39 | 0.80 | 1.24 |
| 1,000 | 0.35 | 2.13 |
| 20,000 | 0.22 | 5.34 |
De la iteración 39 a la 20,000 el error de entrenamiento mejoró 3.6 veces y el error en datos nuevos empeoró 4.3 veces. El optimizador hizo su trabajo de manera impecable: el número que le pedimos bajar, bajó, en todas y cada una de las 20,000 iteraciones. El modelo, mientras tanto, fue aprendiendo cada vez menos.
La razón es la que ya conocen con otro nombre. Al principio el descenso se lleva lo que es fácil de explicar porque se repite en todas las filas: la señal. Cuando ya no queda señal por explicar, lo único que sobra en el error son los accidentes de estas 40 filas en particular, y el algoritmo —que no distingue una cosa de la otra— se dedica a explicar eso. Sesgo primero, varianza después.
De ahí salen las tres técnicas que la sección de sesgo-varianza mencionó sin poder explicar todavía. Las tres son formas de impedir deliberadamente que el optimizador llegue hasta el fondo:
| Técnica | Qué hace, literalmente |
|---|---|
| Early stopping | Detener el ciclo antes del mínimo. En la gráfica: parar en la iteración 39 aunque falten 19,961 iteraciones de mejora disponible |
| Regularización | Cambiar la función de costo para que su mínimo esté en otro lugar, uno con coeficientes más chicos |
| Validación cruzada | No frena nada: es la única forma de saber dónde frenar, porque la curva naranja de la gráfica solo se puede dibujar con datos que el optimizador no vio |
Fíjense en lo que tienen en común los tres números que hacen falta para aplicarlas: la tasa de aprendizaje \(\alpha\), la intensidad de la penalización \(\lambda\), y en qué iteración detenerse. Ninguno de los tres se puede elegir minimizando el error de entrenamiento. Si se pudiera, el propio descenso los elegiría, y su respuesta sería siempre la misma: \(\lambda = 0\), nunca detenerse. Por eso se llaman hiperparámetros y por eso se eligen afuera del ciclo, con datos que el ciclo nunca tocó. Ese es exactamente el tema del capítulo 4.
El optimizador es un empleado obediente y literal: entrega con precisión el mínimo de lo que se le pidió minimizar. Todo el oficio consiste en pedirle lo correcto, y en saber cuándo dejar de pedirle más.
Lo que abre esta sección
De las tres técnicas, la segunda es la que ocupará el resto de esta parte del capítulo. “Cambiar la función de costo” suena abstracto hasta que se ve en la regla de actualización: si al error le sumamos un término que castigue el tamaño de los coeficientes, cada paso se convierte en “acércate a los datos, pero encoge un poco cada coeficiente antes de moverlo”. Esa idea de una sola línea es la que, unas páginas más adelante, tendrá nombre propio: regularización.
Interpretación de Negocios: Caja Blanca
A diferencia de las redes neuronales (“Caja Negra”), la regresión lineal es una “Caja Blanca”: nos dice el por qué.
Ejemplo:
Si nuestro modelo de ventas arroja un coeficiente \(\beta_{\text{marketing}} = 0.75\), esto tiene una traducción directa a la estrategia:
“Ceteris paribus (manteniendo todo lo demás constante), por cada $1,000 adicionales invertidos en marketing, esperamos un incremento de $750 en ventas.”
Esto permite al ingeniero de negocios realizar análisis de Retorno de Inversión (ROI):
- Si el costo del marketing es menor que el retorno marginal ($750 > costo), la decisión lógica es invertir más
- Si el coeficiente es negativo, la actividad está destruyendo valor
Métricas de Evaluación
Para conectar con la fase de Evaluación de CRISP-DM:
1. \(R^2\) (Coeficiente de Determinación)
- Indica qué porcentaje de la variabilidad de los datos es explicado por el modelo
- \(R^2 = 0.85\) significa que nuestro modelo captura el 85% de lo que ocurre en el mercado, dejando 15% a la incertidumbre
2. RMSE (Raíz del Error Cuadrático Medio)
- Nos dice el error promedio en las unidades de la variable objetivo
- Ejemplo: “Nuestro modelo se equivoca, en promedio, por ±$500”
3. MAE (Error Absoluto Medio)
- Promedio de los errores absolutos
- Más robusto a valores atípicos que RMSE
Limitaciones (y no tantas limitaciones)
- Asume linealidad: Si la relación es no lineal, el modelo será inadecuado. ¿Sobre qué asume la linealidad?
- Sensible a outliers: Un solo valor extremo puede distorsionar toda la línea. ¿Qué es lo que hace que esta sensibilidad sea tan alta?
- Multicolinealidad: Si las variables independientes están altamente correlacionadas, los coeficientes se vuelven inestables
Regularización: Ridge y Lasso
Las técnicas de regularización son herramientas fundamentales para combatir el sobreajuste (overfitting) en regresión lineal, conectándose directamente con el trade-off sesgo-varianza discutido anteriormente.
El Problema: Overfitting en Regresión Lineal
Ajustaron un modelo de ventas con doce meses de datos y diez variables predictoras. Tres de ellas —x1, x2 y x3— son tres formas de medir casi lo mismo: gasto en televisión reportado por la agencia, por el proveedor de medios, y por contabilidad. Su correlación entre sí es de 0.9999.
El modelo ajusta los doce meses casi perfectamente. Estos son los coeficientes:
| Variable | Coeficiente |
|---|---|
x1 — gasto TV según la agencia |
−15,709 |
x2 — gasto TV según el proveedor |
−5,260 |
x3 — gasto TV según contabilidad |
+22,201 |
x4 — gasto en radio |
+441 |
x5 |
−49 |
x6 |
−69 |
x7 |
−63 |
x8 |
+34 |
x9 |
+89 |
x10 |
−33 |
Tres preguntas:
- Su jefe pregunta qué significa el coeficiente de
x1. ¿Qué le contesta? - Si el mes entrante la agencia reporta el gasto de televisión con un día de retraso y
x1cambia en 2%, ¿qué le pasa a la predicción? - Sin cambiar de algoritmo ni conseguir más datos, ¿qué le harían al problema de optimización para que dejara de comportarse así?
Pregunta 1: no significa nada interpretable, y hay una forma de demostrarlo. Sumen los tres coeficientes de televisión:
\[-15{,}709 - 5{,}260 + 22{,}201 = 1{,}232\]
Esos datos se generaron con un efecto verdadero de televisión de 1,200. El modelo encontró el efecto total con una precisión excelente, y luego lo repartió entre las tres variables en cantidades absurdas que se cancelan entre sí.
Ahí está el mecanismo completo: con x1, x2 y x3 midiendo lo mismo, Mínimos Cuadrados puede sumarle veinte mil a una y restárselo a otra sin que la predicción cambie ni un peso. No tiene forma de preferir una repartición sobre otra, así que elige cualquiera. Los coeficientes individuales dejan de tener lectura de negocio aunque el modelo en conjunto prediga bien. Eso es multicolinealidad, y es la razón por la que “la regresión lineal es una caja blanca” tiene letras chiquitas.
Si alguien reportara el coeficiente de x1 a la dirección, estaría diciendo que cada peso invertido en televisión destruye 15,709 pesos de ventas. El signo mismo está mal.
Pregunta 2: la predicción se desestabiliza. El equilibrio entre los tres coeficientes gigantes solo se sostiene mientras las tres variables se muevan juntas. En cuanto una se desfasa —un reporte con retraso, un criterio contable distinto, un 2% de diferencia— la cancelación se rompe y un coeficiente de veintidós mil amplifica ese 2% hasta convertirlo en un salto enorme en la predicción.
Ese es exactamente el síntoma de alta varianza que vimos antes: el modelo es frágil ante cambios diminutos en las entradas porque aprendió el ruido de estos doce meses en lugar de la señal.
Pregunta 3: castigar los coeficientes grandes. Si alguien en el equipo propuso “no dejar que los coeficientes crezcan tanto”, acaban de inventar la regularización. La idea es cambiar lo que el modelo intenta minimizar: en lugar de pedirle solo que se acerque a los datos, se le pide que se acerque a los datos y que mantenga sus coeficientes chicos. Ese segundo requisito entra a la función de costo como un término de penalización.
Con esa única idea agregada, los mismos datos producen esto:
| Variable | Sin penalización | Con penalización |
|---|---|---|
x1 — gasto TV según la agencia |
−15,709 | +321 |
x2 — gasto TV según el proveedor |
−5,260 | +320 |
x3 — gasto TV según contabilidad |
+22,201 | +321 |
x4 — gasto en radio |
+441 | +308 |
x5 |
−49 | −31 |
x6 |
−69 | +1 |
x7 |
−63 | +26 |
x8 |
+34 | +11 |
x9 |
+89 | −79 |
x10 |
−33 | +69 |
Miren las tres variables de televisión: +321, +320, +321. En lugar de una cancelación violenta entre veintidós mil y menos quince mil, el modelo reparte el efecto en partes iguales entre las tres mediciones del mismo fenómeno, que es lo único razonable cuando no hay manera de distinguirlas. Y la suma sigue siendo ≈ 962, del mismo orden que el efecto verdadero.
Eso sí es interpretable, y sobre todo es estable: si mañana una de las tres se desfasa, la predicción apenas se mueve.
Falta decidir cómo se castiga, y hay dos maneras con consecuencias muy distintas. Son Ridge y Lasso.
Regresión Ridge (L2)
La Ecuación:
Ridge modifica la función de costo agregando un término de penalización proporcional al cuadrado de los coeficientes:
\[\text{Minimizar: } \sum_{i=1}^{n} (y_{\text{real}}^{(i)} - y_{\text{predicho}}^{(i)})^2 + \lambda \sum_{j=1}^{p} \beta_j^2\]
Donde:
- El primer término es el error estándar (SSE) que ya conocíamos
- El segundo término \(\lambda \sum_{j=1}^{p} \beta_j^2\) es la penalización L2
- \(\lambda\) (lambda) es el parámetro de regularización que controla la intensidad de la penalización
- \(\lambda = 0\) → Regresión lineal estándar (sin penalización)
- \(\lambda\) muy grande → Fuerza todos los coeficientes hacia cero
Cómo se ve desde el descenso en gradiente:
Derivando esa función de costo —con el error escrito como promedio, igual que en la sección anterior— el gradiente gana un solo término extra, \(2\lambda\beta_j\), y la regla de actualización se convierte en:
\[\beta_j \leftarrow \underbrace{\beta_j(1 - 2\alpha\lambda)}_{\text{encoger}} + \underbrace{\frac{2\alpha}{n}\sum_{i=1}^{n} r^{(i)} x_j^{(i)}}_{\text{acercarse a los datos}}\]
Es literalmente el mismo algoritmo de la sección anterior con un paso añadido: antes de moverse hacia los datos, cada coeficiente se encoge un porcentaje fijo. Un coeficiente solo consigue quedarse grande si los datos lo empujan hacia arriba en cada iteración con suficiente fuerza como para compensar ese encogimiento constante. En redes neuronales a esta misma operación se le llama weight decay, y es exactamente la misma fórmula.
Vale la pena notar que la penalización también estabiliza la solución algebraica: la fórmula cerrada de Ridge es \(\hat{\beta} = (X^T X + \lambda I)^{-1}X^T y\), y ese \(\lambda I\) sumado a la diagonal vuelve invertible una matriz que sin él era casi singular. Es la traducción algebraica de la misma idea.
Utilidad de Ridge:
- Reduce Varianza: Al penalizar coeficientes grandes, el modelo se vuelve más estable y generaliza mejor
- Maneja Multicolinealidad: Cuando las variables están correlacionadas, Ridge distribuye el peso entre ellas en lugar de asignar valores erráticos
- Conserva Todas las Variables: Ridge reduce los coeficientes pero nunca los lleva exactamente a cero. Todas las variables permanecen en el modelo
- Ajusta el Trade-off Sesgo-Varianza: Al aumentar \(\lambda\), aumentamos el sesgo ligeramente pero reducimos drásticamente la varianza
Interpretación de Negocio:
Ridge es ideal cuando creemos que todas las variables tienen algún efecto, aunque sea pequeño, y queremos un modelo más robusto a cambio de un poco más de sesgo.
Regresión Lasso (L1)
La Ecuación:
Lasso utiliza una penalización proporcional al valor absoluto de los coeficientes:
\[\text{Minimizar: } \sum_{i=1}^{n} (y_{\text{real}}^{(i)} - y_{\text{predicho}}^{(i)})^2 + \lambda \sum_{j=1}^{p} |\beta_j|\]
La única diferencia con Ridge es que usa \(|\beta_j|\) (penalización L1) en lugar de \(\beta_j^2\) (penalización L2).
Utilidad de Lasso:
- Selección Automática de Variables: Lasso puede forzar coeficientes exactamente a cero, eliminando variables irrelevantes del modelo
- Interpretabilidad: Al producir modelos más simples (con menos variables), facilita la explicación a stakeholders de negocio
- Reduce Varianza: Similar a Ridge, estabiliza el modelo frente al sobreajuste
- Feature Engineering Automático: Actúa como un filtro, identificando las variables más importantes
Interpretación de Negocio:
Lasso es preferible cuando sospechamos que solo un subconjunto de variables es realmente relevante y queremos que el algoritmo identifique cuáles son, produciendo un modelo más simple y explicable.
Comparación Ridge vs. Lasso
| Característica | Ridge (L2) | Lasso (L1) |
|---|---|---|
| Penalización | \(\lambda \sum \beta_j^2\) | \(\lambda \sum \|\beta_j\|\) |
| Selección de Variables | No (reduce pero no elimina) | Sí (puede forzar a cero) |
| Interpretabilidad | Media (todas las variables) | Alta (modelo más simple) |
| Multicolinealidad | Maneja muy bien | Selecciona arbitrariamente una |
| Uso Típico | Todas las variables importan | Identificar variables clave |
| Conexión Sesgo-Varianza | Aumenta sesgo, reduce varianza | Aumenta sesgo, reduce varianza |
Elastic Net: Lo Mejor de Ambos Mundos
En la práctica, existe una técnica que combina ambas penalizaciones:
\[\text{Minimizar: } \text{SSE} + \lambda_1 \sum |\beta_j| + \lambda_2 \sum \beta_j^2\]
Elastic Net es útil cuando tenemos muchas variables correlacionadas y queremos tanto selección como estabilidad.
Selección del Parámetro \(\lambda\)
El valor óptimo de \(\lambda\) se determina mediante Validación Cruzada (la técnica mencionada en el trade-off sesgo-varianza):
- Probamos múltiples valores de \(\lambda\) (e.g., 0.001, 0.01, 0.1, 1, 10, 100)
- Para cada valor, evaluamos el error en datos de validación
- Seleccionamos el \(\lambda\) que minimiza el error de generalización
Regresión Logística: Clasificación y Probabilidad
A menudo, el ingeniero de negocios no necesita predecir “cuánto”, sino “cuál”:
- ¿Es este cliente rentable o no?
- ¿Esta pieza es defectuosa o funcional?
- ¿Este email es spam o legítimo?
Aquí entra la Regresión Logística, la reina de la clasificación binaria.
Por qué Falla la Regresión Lineal en Clasificación
Si intentáramos usar una línea recta para predecir una variable binaria (0 = No Compra, 1 = Compra), encontraríamos problemas graves:
- La línea recta se extiende al infinito
- Para valores extremos de \(x\), el modelo podría predecir 1.5 o -0.3
- En términos de probabilidad, esto es absurdo (no existe un 150% de probabilidad de compra)
La Función Sigmoide
La Regresión Logística transforma la salida de la ecuación lineal mediante la Función Sigmoide (o Logística):
\[P(y=1) = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x)}}\]
Esta función toma cualquier valor numérico (desde \(-\infty\) hasta \(+\infty\)) y lo “aplasta” elegantemente en un rango estricto entre 0 y 1. La curva resultante tiene forma de “S”.
La Función de Pérdida: Cómo se Entrena una Regresión Logística
La sigmoide resuelve el problema de que las predicciones se salgan del rango de 0 a 1. No resuelve el segundo, que es el mismo que tuvimos en la regresión lineal: ¿de dónde salen las \(\beta\)?
Allá la respuesta fue Mínimos Cuadrados: minimizar la suma de los errores al cuadrado. Aquí no puede ser lo mismo, y vale la pena entender por qué antes de escribir la fórmula.
Tres equipos entregaron un modelo de churn. Los evaluaron con los mismos ocho clientes y el mismo umbral de 0.5:
| Cliente | P(churn) A | P(churn) B | P(churn) C | Lo que pasó |
|---|---|---|---|---|
| 1 | 0.55 | 0.95 | 0.95 | Se fue |
| 2 | 0.55 | 0.90 | 0.90 | Se fue |
| 3 | 0.55 | 0.85 | 0.85 | Se fue |
| 4 | 0.45 | 0.45 | 0.02 | Se fue |
| 5 | 0.45 | 0.10 | 0.10 | Se quedó |
| 6 | 0.45 | 0.08 | 0.08 | Se quedó |
| 7 | 0.45 | 0.05 | 0.05 | Se quedó |
| 8 | 0.55 | 0.55 | 0.98 | Se quedó |
Tres preguntas, en equipos:
- Cuenten los aciertos de cada modelo con umbral 0.5. ¿Cuál se llevan a producción?
- Alguien propone: “pues usemos el porcentaje de aciertos como función de costo y que el descenso en gradiente lo maximice”. Denme dos razones por las que eso no puede funcionar.
- ¿Qué tendría que castigar la función de costo para que el modelo C quedara descalificado?
Pregunta 1: los tres aciertan exactamente lo mismo, y no valen lo mismo. Los tres se equivocan en el cliente 4 y en el 8, y aciertan en los otros seis. Su matriz de confusión es idéntica: 3 TP, 1 FP, 1 FN, 3 TN.
| Modelo | TP | FP | FN | TN | Accuracy | Error cuadrático | Log-loss |
|---|---|---|---|---|---|---|---|
| A — tímido | 3 | 1 | 1 | 3 | 0.75 | 0.228 | 0.648 |
| B — seguro | 3 | 1 | 1 | 3 | 0.75 | 0.082 | 0.270 |
| C — temerario | 3 | 1 | 1 | 3 | 0.75 | 0.247 | 1.048 |
Si su reporte a la dirección se detiene en la matriz de confusión, los tres modelos son el mismo modelo. Y basta mirar las probabilidades para ver que no:
- A nunca se compromete. Todo lo pone entre 0.45 y 0.55. Es inservible para priorizar: si el call center tiene presupuesto para llamar a tres clientes, A no dice a cuáles.
- B ordena bien y con convicción. Sus tres aciertos positivos son 0.95, 0.90 y 0.85; sus dos errores son 0.45 y 0.55, es decir, falla dudando, que es la forma correcta de fallar.
- C es idéntico a B en seis clientes y catastrófico en dos. Le dijo 0.02 a un cliente que se fue y 0.98 a uno que se quedó. Si al de 0.98 le colgaron una oferta de retención de $50,000, ese dinero ya salió por la puerta.
Lo que distingue a los tres no es la clasificación: es la probabilidad. Cualquier función de costo que solo mire etiquetas es ciega a la diferencia.
Pregunta 2: el porcentaje de aciertos no se puede optimizar por gradiente. Dos razones:
- Es ciego, como acabamos de ver: empata a A, B y C en 0.75.
- Su derivada es cero casi en todas partes. El porcentaje de aciertos solo cambia cuando una probabilidad cruza el umbral. Muevan \(\beta\) un poquito: si ninguna predicción cruza 0.5, el número no se mueve —pendiente 0, el descenso en gradiente se queda parado—. Y cuando una cruza, salta de golpe: pendiente infinita. Volviendo a la metáfora de la montaña: no es una ladera, es una escalera. Escalones planos y paredes verticales. Los pies no sienten para dónde bajar.
Pregunta 3: hay que castigar la confianza equivocada, y sin techo. Si el castigo tiene tope, un error catastrófico cuesta lo mismo que uno tímido. Miren el error cuadrático, que sí distingue calidad de probabilidad y por eso no es una mala idea: con \((y - p)^2\) el peor error posible cuesta 1. Por eso C (0.247) le sale apenas peor que A (0.228), aunque C haya quemado $50,000 y A solo sea inútil.
El castigo que necesitamos crece sin límite cuando el modelo le asigna una probabilidad cercana a cero a lo que efectivamente pasó. Ese castigo es el logaritmo:
| \(p\) que asignó el modelo | Error cuadrático \((1-p)^2\) | Log-loss \(-\ln p\) |
|---|---|---|
| 0.99 | 0.000 | 0.01 |
| 0.90 | 0.010 | 0.11 |
| 0.70 | 0.090 | 0.36 |
| 0.50 | 0.250 | 0.69 |
| 0.30 | 0.490 | 1.20 |
| 0.10 | 0.810 | 2.30 |
| 0.01 | 0.980 | 4.61 |
| 0.001 | 0.998 | 6.91 |
(la tabla supone que el cliente sí se fue, \(y = 1\))
El error cuadrático sube de 0.98 a 0.998 —prácticamente no distingue— entre equivocarse con 99% de seguridad y equivocarse con 99.9%. El logaritmo pasa de 4.61 a 6.91 y sigue subiendo hacia el infinito. Con esa función de costo, C ya no empata: sale cuatro veces peor que B (1.048 contra 0.270), que es exactamente lo que el negocio siente.
Si alguien en su equipo dijo “cóbrenle caro al que jura y se equivoca”, acaban de inventar el log-loss.
La fórmula: log-loss (o entropía cruzada)
Para un solo cliente, con \(p^{(i)}\) la probabilidad que el modelo le asignó a la clase 1 y \(y^{(i)} \in \{0, 1\}\) lo que realmente pasó:
\[\text{pérdida}^{(i)} = -\left[\, y^{(i)}\ln p^{(i)} + \left(1 - y^{(i)}\right)\ln\left(1 - p^{(i)}\right)\,\right]\]
El truco de esa expresión es que \(y^{(i)}\) solo puede valer 0 o 1, así que siempre se apaga uno de los dos términos:
- Si el cliente se fue (\(y = 1\)), queda \(-\ln p\): el castigo por la probabilidad que le diste al churn.
- Si se quedó (\(y = 0\)), queda \(-\ln(1 - p)\): el castigo por la probabilidad que le diste a que se quedara.
En los dos casos es la misma frase: el logaritmo negativo de la probabilidad que le asignaste a lo que en realidad ocurrió. Le atinaste con seguridad, pagas casi nada; te equivocaste con seguridad, pagas una fortuna.
Promediando sobre los \(n\) clientes queda la función de costo completa:
\[J(\beta) = -\frac{1}{n}\sum_{i=1}^{n}\left[\, y^{(i)}\ln p^{(i)} + \left(1 - y^{(i)}\right)\ln\left(1 - p^{(i)}\right)\,\right] \qquad \text{con} \qquad p^{(i)} = \frac{1}{1 + e^{-\left(\beta_0 + \beta_1 x_1^{(i)} + \dots + \beta_p x_p^{(i)}\right)}}\]
Esta función tiene dos nombres según quién la use: log-loss en machine learning, entropía cruzada (cross-entropy) en teoría de la información. Es la misma fórmula, y es la que entrena desde este modelo hasta un modelo de lenguaje.
De dónde sale: máxima verosimilitud
El log-loss no se inventó para que la tabla anterior saliera bonita. Sale de una pregunta estadística legítima: ¿qué valores de \(\beta\) hacen que los datos que efectivamente observamos sean lo más creíbles posible?
Si el modelo dice que el cliente \(i\) se va con probabilidad \(p^{(i)}\), entonces la probabilidad de haber observado lo que observamos en ese cliente es \(p^{(i)}\) si se fue, y \(1 - p^{(i)}\) si se quedó. Las dos se escriben de un jalón como \(\left(p^{(i)}\right)^{y^{(i)}}\left(1 - p^{(i)}\right)^{1 - y^{(i)}}\). Si los clientes son independientes, la probabilidad de la muestra completa es el producto:
\[L(\beta) = \prod_{i=1}^{n} \left(p^{(i)}\right)^{y^{(i)}}\left(1 - p^{(i)}\right)^{1 - y^{(i)}}\]
A eso se le llama verosimilitud (likelihood), y queremos el \(\beta\) que la maximice. Tal como está no sirve: multiplicar diez mil números menores que 1 da un resultado que ninguna computadora puede representar, y derivar un producto de diez mil factores es un ejercicio de masoquismo. La solución es tomar logaritmo —que convierte productos en sumas y no cambia dónde está el máximo, porque es una función creciente— y ponerle un signo menos para pasar de maximizar a minimizar:
\[-\ln L(\beta) = -\sum_{i=1}^{n}\left[\, y^{(i)}\ln p^{(i)} + \left(1 - y^{(i)}\right)\ln\left(1 - p^{(i)}\right)\,\right] \; = \; n \cdot J(\beta)\]
Es exactamente el log-loss. La traducción de negocio es esta:
Minimizar el log-loss es elegir el modelo bajo el cual la historia que realmente ocurrió era la más creíble.
El gradiente: la misma regla de actualización de antes
Ya tenemos qué minimizar. Falta cómo, y la respuesta es la de la sección de regresión lineal: descenso en gradiente. Derivando \(J\) respecto a un coeficiente cualquiera —la sigmoide y el logaritmo se cancelan de una forma casi milagrosa— queda:
\[\frac{\partial J}{\partial \beta_j} = -\frac{1}{n}\sum_{i=1}^{n} \underbrace{\left(y^{(i)} - p^{(i)}\right)}_{\text{residuo } r^{(i)}} x_j^{(i)}\]
Y la regla de actualización:
\[\beta_j \leftarrow \beta_j + \frac{\alpha}{n}\sum_{i=1}^{n} r^{(i)} x_j^{(i)} \qquad \text{con} \qquad r^{(i)} = y^{(i)} - p^{(i)}\]
Compárenla con la de la regresión lineal. Es la misma línea. Lo único que cambia es qué significa el residuo: allá era \(y - \hat{y}\), pesos que faltaron; aquí es \(y - p\), la distancia entre lo que pasó (0 o 1) y la probabilidad que el modelo le había asignado. Un cliente al que el modelo le dio 0.9 y se fue aporta \(r = 0.1\): casi nada, ya estaba bien clasificado. Uno al que le dio 0.1 y se fue aporta \(r = 0.9\): mueve los coeficientes con fuerza.
La lectura de negocio también es la misma: si los clientes en los que el modelo todavía se equivoca son justamente los de muchas quejas, la suma \(\sum r^{(i)} x_j^{(i)}\) es positiva y el coeficiente de quejas sube.
Además de castigar poco los errores graves, tiene un problema mecánico. Al derivar \((y - p)^2\) con \(p\) pasando por la sigmoide, aparece un factor extra \(p(1-p)\) que se hace diminuto en los extremos. Vean qué corrección recibe cada regla cuando el modelo está seguro y equivocado (el cliente se quedó, \(y = 0\)):
| \(p\) que dijo el modelo | Corrección con log-loss | Corrección con error cuadrático |
|---|---|---|
| 0.60 | 0.600 | 0.288 |
| 0.90 | 0.900 | 0.162 |
| 0.99 | 0.990 | 0.020 |
| 0.999 | 0.999 | 0.002 |
Con el error cuadrático, el aprendizaje se paraliza justo donde más falta hace: en \(p = 0.999\) corrige 500 veces menos que el log-loss. El modelo se queda atorado en su error, seguro de sí mismo. El log-loss corrige en proporción directa a lo equivocado que estaba. Este mismo fenómeno —el gradiente que se desvanece— reaparecerá en el capítulo de redes neuronales, y la solución será la misma función de costo.
Una diferencia importante con la regresión lineal
En la regresión lineal existía la fórmula cerrada \(\hat{\beta} = (X^TX)^{-1}X^Ty\): el descenso en gradiente era una elegancia, no una necesidad. Aquí no hay fórmula cerrada. La ecuación \(\nabla J(\beta) = 0\) mezcla los coeficientes dentro de una exponencial y no se puede despejar a mano, ni con álgebra, ni con paciencia.
La buena noticia es que \(J\) es convexa: tiene un solo mínimo, sin valles falsos donde atorarse. Cualquier método iterativo decente —descenso en gradiente, o su versión acelerada de segundo orden que usan scikit-learn y statsmodels— llega al óptimo global. Es decir: en la regresión logística, el algoritmo de la sección anterior no es una alternativa. Es la única puerta de entrada.
Elegir la función de pérdida es la decisión de negocio disfrazada de detalle técnico. Pedir log-loss es pedirle al modelo probabilidades honestas; pedir porcentaje de aciertos es pedirle etiquetas y renunciar a todo lo demás. El optimizador va a entregar, con precisión, el mínimo de lo que se le pidió.
Interpretación de los Coeficientes: Momios y Odds Ratios
La regresión logística sigue siendo una caja blanca, pero la lectura ya no es tan directa como en la lineal. Allá \(\beta = 0.75\) significaba “750 pesos más de ventas” y se acababa la discusión. Aquí el modelo no predice pesos: predice probabilidad, y la predice a través de la sigmoide. El coeficiente vive en otra escala, y confundirlas es el error más común al presentar estos modelos.
Este es un modelo de churn ajustado sobre 20,000 clientes de una empresa de telecomunicaciones:
| Variable | \(\beta\) |
|---|---|
| Quejas registradas (por queja) | +0.80 |
| Antigüedad como cliente (por mes) | −0.032 |
| Tuvo descuento (sí = 1) | −0.65 |
| Gasto mensual (por cada $100) | +0.20 |
| Intercepto | −1.08 |
Dos analistas presentan el mismo modelo a la dirección:
- Ana: “cada queja adicional sube la probabilidad de churn en 0.80; o sea, 80 puntos porcentuales”.
- Beto: “cada queja adicional sube la probabilidad de churn un 80%”.
Tres preguntas:
- ¿Quién tiene razón? Pruébenlo con un cliente que ya traía 40% de riesgo y registra dos quejas.
- Dos clientes registran una queja cada uno: el primero venía en 5% de riesgo, el segundo en 50%. ¿A cuál le sube más la probabilidad?
- ¿Es “quejas” (\(+0.80\)) veinticinco veces más importante que “antigüedad” (\(-0.032\))?
Pregunta 1: ninguno de los dos, y el contraejemplo los tumba a los dos. Con la lectura de Ana, el cliente de 40% con dos quejas queda en \(40\% + 2 \times 80 = 200\%\). Con la de Beto, en \(40\% \times 1.8 \times 1.8 = 129.6\%\). Las dos se salen del rango, y la sigmoide existe precisamente para que eso no pase.
El problema es que ninguna de las dos lecturas opera en la escala correcta. Lo que es lineal en la regresión logística no es la probabilidad: es el logaritmo de los momios. Despejando la sigmoide:
\[\ln\left(\frac{p}{1 - p}\right) = \beta_0 + \beta_1 x_1 + \dots + \beta_p x_p\]
Los momios (odds) son la razón “a favor entre en contra”. Una probabilidad de 20% es un momio de \(0.20/0.80 = 0.25\), o “una a cuatro”. Es la escala de las apuestas, y su rango va de 0 a infinito, no de 0 a 1. El lado izquierdo se llama logit, y la frase correcta es: la regresión logística es lineal en el logit.
Entonces \(\beta\) es cuánto se le suma al logaritmo de los momios por una unidad más de la variable. Y como sumar en logaritmos es multiplicar afuera:
\[e^{0.80} = 2.23\]
“Cada queja registrada multiplica por 2.23 los momios de que el cliente se vaya, manteniendo todo lo demás constante.”
Ese \(e^{\beta}\) se llama odds ratio (razón de momios) y es la forma estándar de reportar una logística. Con esa lectura, el cliente de 40% —momios 0.667— con dos quejas queda en \(0.667 \times 2.23 \times 2.23 = 3.31\) de momios, es decir 76.8% de probabilidad. Dentro del rango, siempre.
Pregunta 2: al de 50%, y por mucho. Los momios de los dos se multiplican por el mismo 2.23, pero eso se traduce en cambios de probabilidad muy distintos:
| Probabilidad antes | Momios antes | Momios después | Probabilidad después | Cambio |
|---|---|---|---|---|
| 2% | 0.020 | 0.045 | 4.3% | +2.3 pp |
| 5% | 0.053 | 0.117 | 10.5% | +5.5 pp |
| 20% | 0.250 | 0.556 | 35.7% | +15.7 pp |
| 50% | 1.000 | 2.226 | 69.0% | +19.0 pp |
| 80% | 4.000 | 8.902 | 89.9% | +9.9 pp |
| 95% | 19.000 | 42.285 | 97.7% | +2.7 pp |
El de 5% sube 5.5 puntos; el de 50% sube 19. Y el de 95% casi no se mueve (+2.7) aunque sus momios también se dupliquen: ya estaba perdido, no hay a dónde subir. El efecto en probabilidad es máximo en la parte empinada de la S y se aplana en los dos extremos — es la forma de la sigmoide, otra vez.
Ahí está el resultado que importa para el negocio: el mismo coeficiente vale distinto para cada cliente. Es lo contrario de la regresión lineal, donde \(\beta = 0.75\) valía 750 pesos para todos. Por eso una campaña de retención rinde más en la franja media de riesgo que en los extremos.
Para el pasillo, hay una aproximación útil: la regla de dividir entre 4. El cambio máximo en probabilidad, en el punto más empinado, es a lo más \(\beta/4\). Aquí \(0.80/4 = 0.20\), y el máximo real es 0.197. Es decir: “a lo más 20 puntos porcentuales, y menos en los extremos”.
Pregunta 3: no, porque las escalas no son comparables. El \(+0.80\) es por queja y el \(-0.032\) es por mes. Nadie acumula 25 quejas, pero cualquier cliente acumula 25 meses de antigüedad — y \(25 \times (-0.032) = -0.80\) cancela exactamente una queja. El tamaño del coeficiente depende de las unidades en que se midió la variable, así que compararlos crudos no dice nada.
Para comparar hay que ponerlos en unidades comunes. La forma estándar es el efecto de una desviación estándar de cada variable:
| Variable | \(\beta\) estandarizado | \(e^{\beta}\) |
|---|---|---|
| Quejas | +0.80 | 2.23 |
| Antigüedad | −0.54 | 0.58 |
| Gasto mensual | +0.40 | 1.49 |
| Descuento | −0.31 | 0.73 |
Es el mismo modelo, leído en unidades comparables, y el orden cambia: la antigüedad pasa al segundo lugar, muy por delante del descuento. Lo que parecía un coeficiente despreciable era la segunda variable más importante del modelo.
Cómo se lee un coeficiente, en la práctica
Tres pasos, siempre los mismos:
- El signo dice la dirección: positivo sube el riesgo, negativo lo baja.
- \(e^{\beta}\) dice el tamaño, y se lee sobre los momios: mayor que 1 los multiplica, menor que 1 los divide.
- El contexto del cliente dice cuánto es eso en probabilidad — que es la tabla de la resolución anterior, no un número fijo.
Aplicado al modelo completo:
| Variable | \(\beta\) | \(e^{\beta}\) | Lectura para la dirección |
|---|---|---|---|
| Quejas (por queja) | +0.80 | 2.23 | Cada queja duplica y un poco más los momios de churn (+123%) |
| Antigüedad (por mes) | −0.032 | 0.969 | Cada mes los baja 3.1%; un año completo los deja en \(0.969^{12} = 0.68\), es decir −32% |
| Descuento (sí) | −0.65 | 0.52 | Tener descuento corta los momios casi a la mitad (−48%) |
| Gasto mensual (por $100) | +0.20 | 1.22 | Cada $100 de gasto los sube 22%: los clientes de plan alto son más volátiles |
Dos notas sobre la mecánica:
- Los efectos se acumulan multiplicando. Un cliente con tres quejas y dos años de antigüedad tiene sus momios multiplicados por \(2.23^3 \times 0.969^{24} = 11.1 \times 0.47 = 5.2\). En la escala de los momios todo se multiplica; en la del logit, todo se suma.
- El intercepto es el logit cuando todas las variables valen cero. Aquí, \(-1.08\) corresponde a momios de 0.34 y una probabilidad de 25.4%: el riesgo de un cliente recién llegado, sin quejas, sin descuento y con gasto promedio. Solo tiene lectura de negocio si ese cliente existe; cuando “todas las variables en cero” describe a nadie, el intercepto es puro ajuste algebraico.
- Confundir odds ratio con riesgo relativo. “Multiplica los momios por 2.23” no es “multiplica la probabilidad por 2.23” (véase la tabla: 50% no se va a 111%). Solo cuando el evento es raro (\(p < 5\%\)) los dos números se parecen — y ahí viene la confusión, porque en fraude y en default suelen parecerse lo suficiente para que nadie note el error hasta que el evento deja de ser raro.
- Leer una dummy sin decir contra qué. “Plan Premium: odds ratio 1.4” no significa nada si no se dice frente a qué categoría base. Todo coeficiente de variable categórica es una comparación contra la categoría que se dejó fuera.
- Interpretar coeficientes con variables correlacionadas. El “manteniendo todo lo demás constante” tiene las mismas letras chiquitas que en la regresión lineal: si dos variables miden casi lo mismo, sus coeficientes se reparten el efecto de forma arbitraria y ninguno de los dos es interpretable. Es el problema de la sección siguiente.
- Leer \(\beta\) como causalidad. El modelo midió una asociación en datos históricos. Borrar las quejas de la base no reduce el churn de nadie; el coeficiente no dice qué pasa si intervenimos, dice qué pasó cuando observamos.
Probabilidad vs. Etiqueta Pura: El Valor Real para el Negocio
El valor real de la regresión logística no es solo la clasificación final, sino la Probabilidad subyacente.
El modelo no dice simplemente “Este cliente se irá (Churn)”. Dice: “Este cliente tiene una probabilidad del 78% de irse”.
Esto permite una gestión matizada del riesgo:
| Cliente | Probabilidad de Churn | Clasificación (>50%) | Estrategia de Negocio |
|---|---|---|---|
| A | 51% | Churn | Salvable con llamada proactiva |
| B | 78% | Churn | Requiere oferta agresiva de retención |
| C | 99% | Churn | Probablemente perdido, no invertir recursos |
| D | 15% | No Churn | Cliente satisfecho, mantener servicio |
Un cliente con 51% de riesgo y uno con 99% se clasifican igual (ambos > 50%), pero la estrategia debe ser diferente.
El Umbral de Decisión (Thresholding)
Para tomar una acción (enviar cupón o no), debemos convertir la probabilidad en una decisión binaria estableciendo un Umbral (típicamente 0.5):
- Si \(P > 0.5\) → Predecir 1 (Evento Positivo)
- Si \(P < 0.5\) → Predecir 0 (Evento Negativo)
Sin embargo, el ingeniero de negocios inteligente ajusta este umbral basándose en la Matriz de Costos.
Ejemplo: Detección de Fraude
Matriz de Costos:
- Falso Positivo: Predecimos fraude, pero es un cliente legítimo → Costo: Molestia al cliente ($10)
- Falso Negativo: Predecimos legítimo, pero es fraude → Costo: Pérdida financiera directa ($5,000)
Si el costo del fraude es muy alto, podemos bajar el umbral a 0.2:
“Si hay más de un 20% de probabilidad de que sea fraude, bloquéalo”
Esto aumenta los falsos positivos pero atrapa más fraudes. La regresión logística permite esta calibración estratégica.
Métricas de Evaluación
Para la fase de Evaluación de CRISP-DM:
1. Matriz de Confusión
| Predicho: Negativo | Predicho: Positivo | |
|---|---|---|
| Real: Negativo | Verdadero Negativo (TN) | Falso Positivo (FP) |
| Real: Positivo | Falso Negativo (FN) | Verdadero Positivo (TP) |
2. Métricas Derivadas
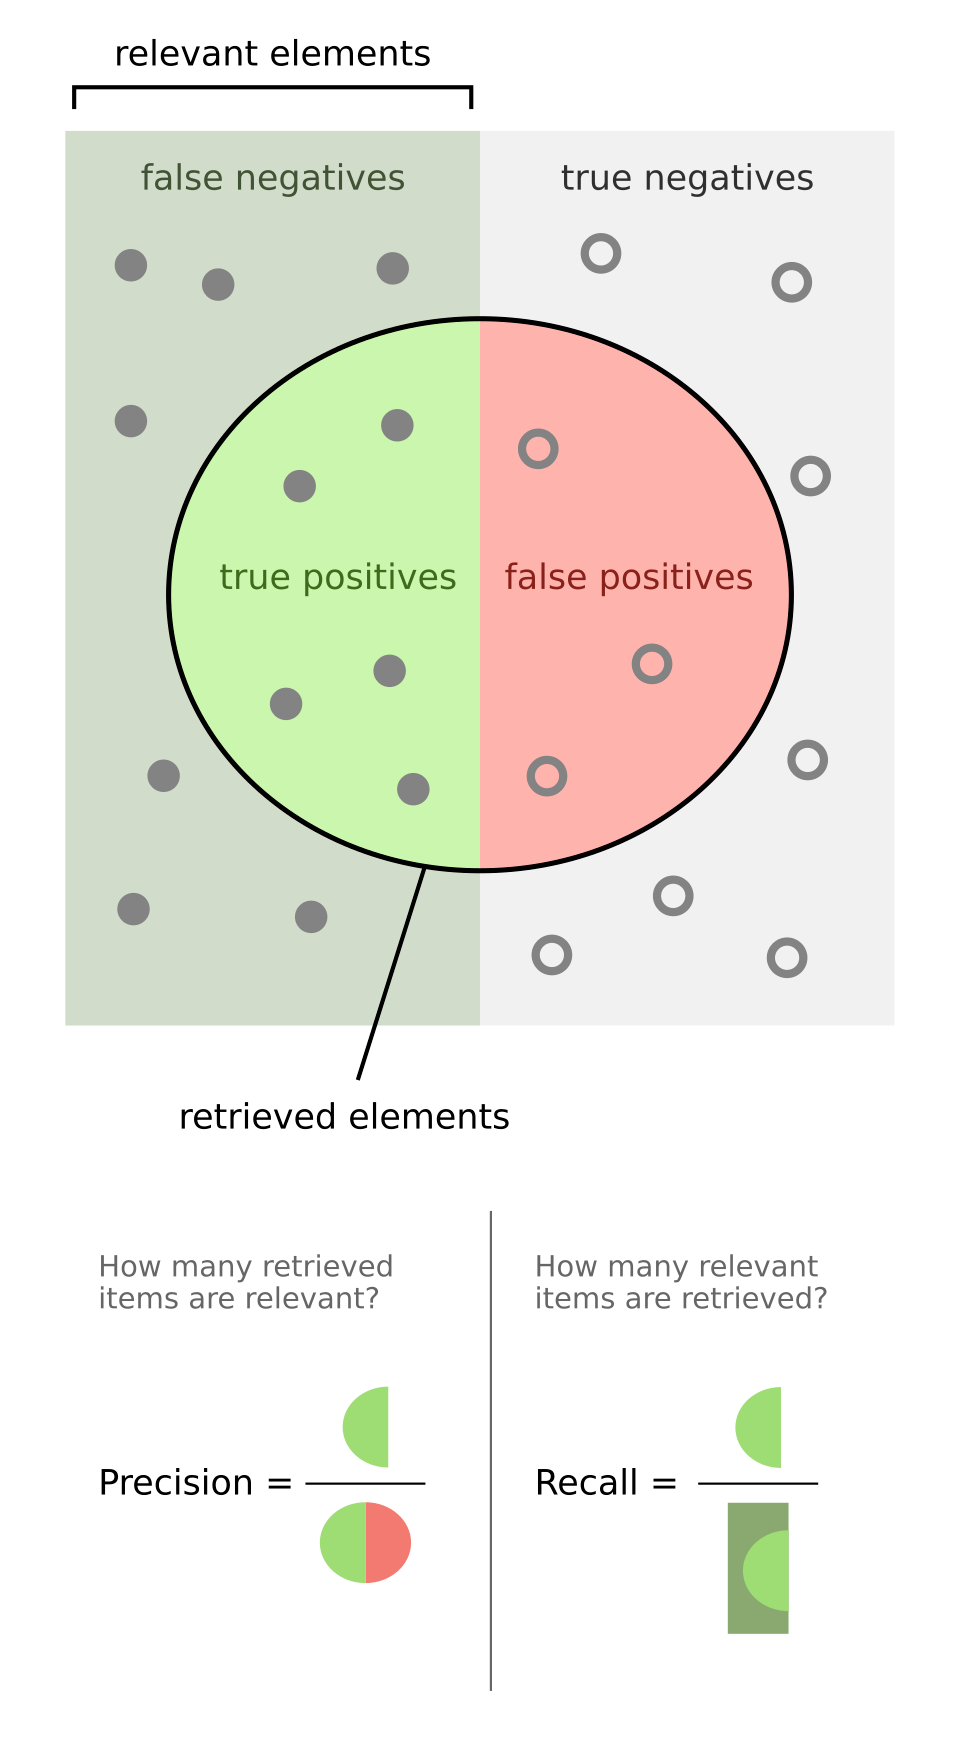
- Accuracy (Exactitud): ¿Qué porcentaje de predicciones fueron correctas? \[\dfrac{TP + TN}{\text{Total}}\]
- Tasa de falsos positivos: De todas las veces que la realidad era negativa, ¿qué porcentaje de veces el modelo se equivocó y dijo positivo? \[\dfrac{FP}{\text{FP + TP}} = \dfrac{FP}{\textbf{Real}\text{: Negativo}}\]
- Precision (Precisión): De lo que predijimos como positivo, ¿cuánto realmente lo era? \[\dfrac{TP}{TP + FP} = \dfrac{TP}{\textbf{Predicho}\text{: Positivo}}\]
- Recall (Sensibilidad): De todos los casos positivos reales, ¿cuántos detectamos? \[\dfrac{TP}{TP + FN} = \dfrac{TP}{\textbf{Real}\text{: Positivo}}\]
- F1-Score: Media armónica de Precision y Recall
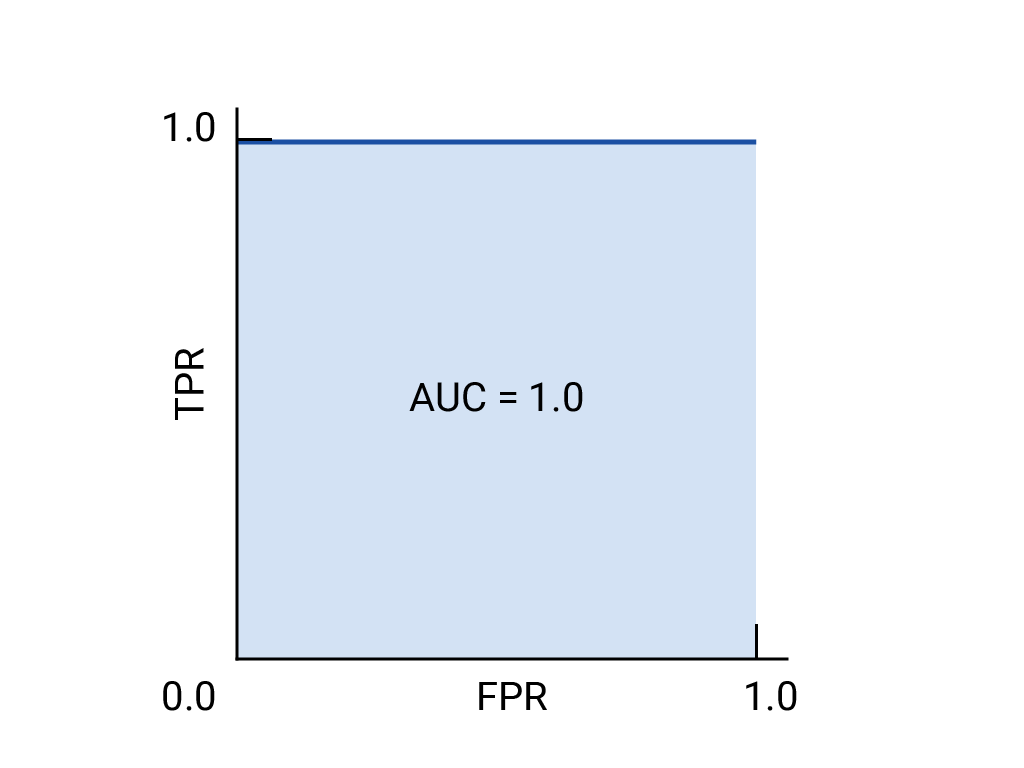
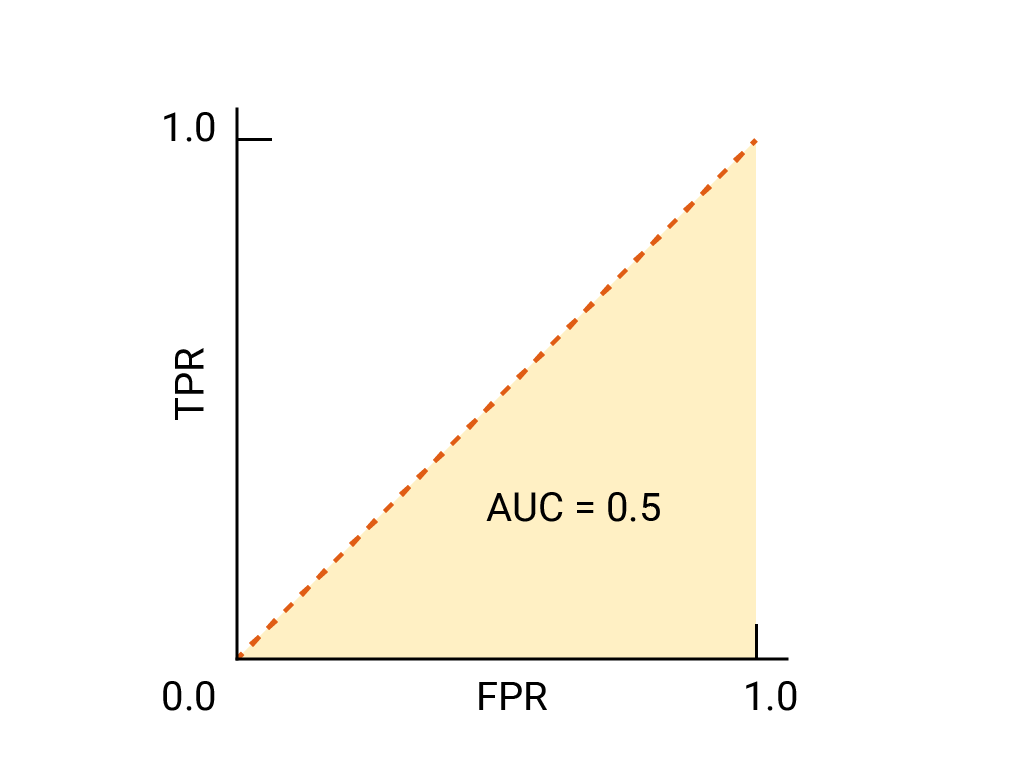
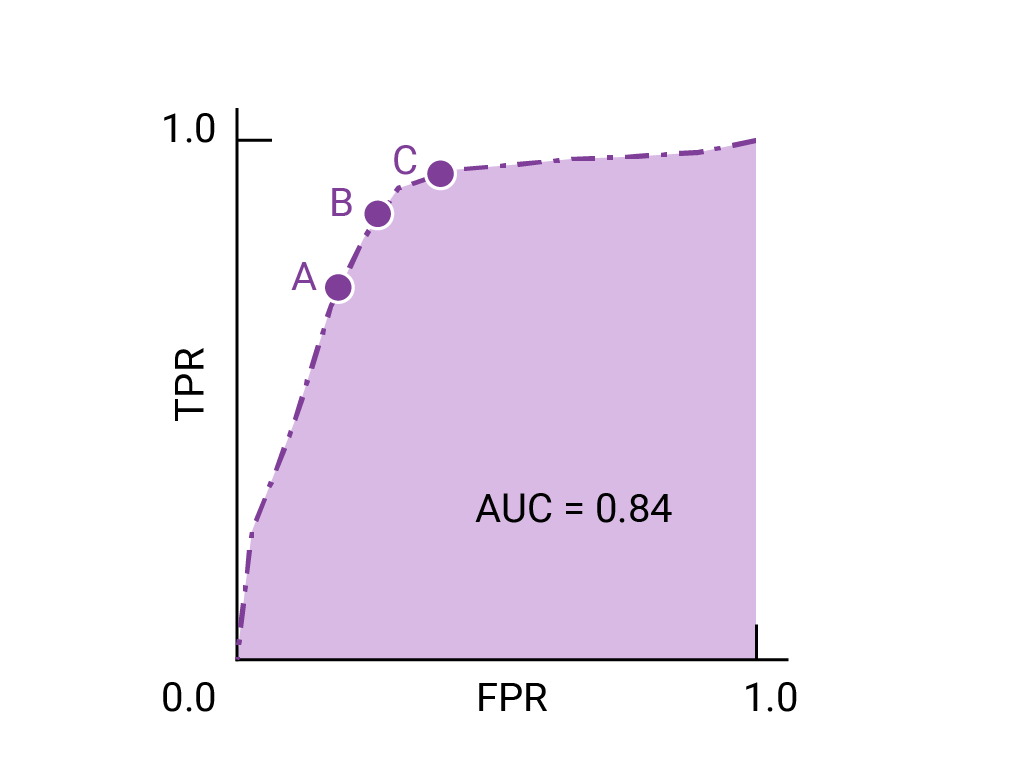
3. Curva ROC
Básicamente una gráfica que nos dice qué tan bueno es un modelo para distinguir entre dos categorías bajo diferentes umbrales.
- ¿Qué dibuja?
- Eje Y: Sensibilidad
- Eje X: Tasa de falsos positivos
- ¿Qué varía? Los puntos de corte
Regularización en Regresión Logística: Ridge y Lasso
Conceptualmente no hay nada nuevo respecto a la sección de regresión lineal: a la función de costo se le suma un término que castiga el tamaño de los coeficientes. Lo único que cambia es el primer término, que ya no es la suma de cuadrados sino el log-loss:
\[\text{Ridge (L2): } \quad \underbrace{-\frac{1}{n}\sum_{i=1}^{n}\left[y^{(i)}\ln p^{(i)} + \left(1-y^{(i)}\right)\ln\left(1-p^{(i)}\right)\right]}_{\text{log-loss}} \; + \; \lambda \sum_{j=1}^{p} \beta_j^2\]
\[\text{Lasso (L1): } \quad \text{log-loss} \; + \; \lambda \sum_{j=1}^{p} |\beta_j|\]
Las consecuencias son las mismas que allá, y por las mismas razones: L2 encoge todos los coeficientes y reparte el efecto entre variables correlacionadas sin eliminar ninguna; L1 manda coeficientes exactamente a cero y hace selección de variables. La regla de actualización también gana el mismo paso extra —encoger antes de moverse hacia los datos— sobre el gradiente \(r^{(i)} = y^{(i)} - p^{(i)}\) de la sección anterior.
Lo que sí es nuevo es por qué aquí la regularización no es opcional.
Un equipo ajusta una logística de churn con 40 clientes. Entre las variables está solicitó_baja: si el cliente llamó al call center a pedir la cancelación durante el mes. En la muestra, los 20 clientes que llamaron se fueron, y ninguno de los otros 20 se fue.
Ajustan el modelo sin penalización y reportan:
| Variable | \(\beta\) | \(e^{\beta}\) |
|---|---|---|
solicitó_baja |
+17.45 | 37,847,664 |
quejas |
+0.17 | 1.19 |
Tres preguntas:
- El odds ratio dice que pedir la baja multiplica los momios de churn por 37 millones. ¿Qué le contestan a la dirección?
- Un compañero corre el mismo código con más iteraciones del optimizador y le sale \(\beta = +23\). Otro, con menos, obtiene \(+9\). ¿Cuál de los tres es el correcto?
- Este problema tiene dos arreglos: uno al problema de optimización y otro a la definición del problema de negocio. ¿Cuáles son?
Pregunta 1: que ese número no significa nada, porque no existe. Lo que hay aquí se llama separación perfecta: una variable que parte la muestra en dos sin un solo caso que contradiga la regla.
Piénsenlo desde el log-loss. Con \(\beta = 17\), el modelo le asigna a los que pidieron la baja una probabilidad de churn de 0.99999997, y paga un castigo diminuto pero positivo. Con \(\beta = 30\) la probabilidad se acerca aún más a 1 y el castigo baja otro poquito. Con \(\beta = 100\), otro poquito más. Nunca hay una razón para detenerse: mientras ningún dato contradiga la regla, agrandar el coeficiente siempre mejora la pérdida.
El log-loss sigue siendo convexo, pero su mínimo está en el infinito y no se alcanza nunca. No hay estimación que reportar.
Pregunta 2: ninguno de los tres. Los tres números son “el punto donde el optimizador se rindió”, y ese punto depende del número de iteraciones, de la tolerancia y del solver que se usó. Un coeficiente que cambia según el presupuesto de cómputo no es una estimación de nada. Por eso scikit-learn levanta un ConvergenceWarning en estos casos: es el modelo avisando que la pregunta está mal planteada.
Además, esa fragilidad es varianza en su forma más extrema: basta un solo cliente nuevo que llame a cancelar y se quede para que el coeficiente se desplome de 17 a 3.
Pregunta 3, arreglo al problema de optimización: penalizar. El término \(\lambda\sum\beta_j^2\) le pone precio a crecer. Ahora cada unidad extra de coeficiente compra una mejora cada vez más pequeña en el log-loss y paga un costo cada vez mayor en la penalización; en algún punto deja de convenir, y ahí vuelve a existir un mínimo, único y finito:
| Penalización | \(\beta\) de solicitó_baja |
\(e^{\beta}\) | \(\beta\) de quejas |
|---|---|---|---|
| Ninguna (\(\lambda = 0\)) | +17.45 | 37,847,664 | +0.17 |
Ridge débil (C = 100) |
+10.43 | 33,727 | +0.23 |
Ridge (C = 1) |
+3.21 | 24.7 | +0.26 |
Ridge fuerte (C = 0.1) |
+0.78 | 2.2 | +0.22 |
Con Ridge estándar el coeficiente queda en +3.21, un odds ratio de 24.7: “pedir la baja multiplica por 25 los momios de irse”. Eso sí es reportable, y sobre todo es estable: no cambia si el optimizador corre el doble de iteraciones.
Arreglo al problema de negocio: preguntarse de dónde salió esa variable. Una variable que separa perfectamente casi nunca es un hallazgo; casi siempre es fuga de información (data leakage). “Solicitó la baja” no predice la cancelación: es la cancelación, registrada un día antes en otro sistema. En producción, el día que hay que decidir a quién llamar, esa columna todavía está vacía para todos.
Ahí está la parte incómoda: Ridge arregla el síntoma numérico y puede esconder el diagnóstico. Con la penalización, el modelo deja de tronar, reporta un odds ratio razonable y presenta un AUC de 0.99 en validación — y no vale nada en producción. La estabilidad numérica no convierte una fuga en una predicción.
Lasso: el selector de variables en clasificación
El otro uso, idéntico al de la regresión lineal, es quedarse con las variables que importan. Con 300 clientes y 20 variables, de las cuales solo 4 tienen efecto real:
| Modelo | Variables con coeficiente ≠ 0 | ¿Conservó las 4 relevantes? |
|---|---|---|
| Sin penalización | 20 de 20 | Sí |
Ridge (C = 1) |
20 de 20 | Sí |
Lasso (C = 0.1) |
5 de 20 | Sí |
Lasso (C = 0.05) |
4 de 20 | Sí |
Lasso apaga 15 de las 16 variables inútiles sin perder ninguna de las cuatro buenas. Sin penalización y con Ridge sobreviven las 20, cada una con su coeficiente chiquito y su interpretación espuria — y alguien, en alguna junta, va a leer en voz alta el odds ratio de una de esas 16.
Por eso en clasificación de negocio Lasso suele ganar por razones que no son estadísticas: un scorecard de riesgo de crédito se audita variable por variable ante un regulador, y un modelo de 8 variables con odds ratios defendibles vale más que uno de 200 con 0.01 más de AUC.
Existe también Elastic Net, que combina las dos penalizaciones y es la opción razonable cuando hay muchas variables correlacionadas y se quiere selección.
1. En scikit-learn, C no es \(\lambda\): es su inverso.
\[C = \frac{1}{\lambda}\]
Cgrande (100, 1000) → penalización débil, coeficientes libresCchico (0.1, 0.01) → penalización fuerte, coeficientes encogidos
Es al revés de lo que dicta la intuición, y de ahí sale la mitad de los errores en tareas y exámenes.
2. LogisticRegression regulariza por default. Su valor de fábrica es C = 1.0 con penalización L2 activa: si ajustan un modelo sin tocar nada, ya está regularizado. Cuando sus coeficientes no coinciden con los de statsmodels (que no penaliza), ésta es la razón. Para pedir explícitamente que no penalice se usa C = np.inf.
3. Hay que estandarizar. La penalización castiga el tamaño de los coeficientes, y ese tamaño depende de las unidades: una variable medida en pesos tiene coeficientes minúsculos y una medida en millones los tiene grandes, aunque su efecto real sea el mismo. Sin estandarizar, la penalización castiga arbitrariamente a unas variables y perdona a otras. El intercepto, por convención, no se penaliza.
Cómo elegir \(\lambda\) (o C)
Con validación cruzada, igual que en la regresión lineal: se prueba una malla de valores, se evalúa el error en datos que el modelo no vio, y se elige el que mejor generaliza.
Aquí se cierra el círculo con la primera sección de este tema: el criterio con el que eligen C debe ser la métrica que le importa al negocio, y si lo que van a usar son probabilidades, esa métrica es el log-loss (o el AUC, si lo único que importa es ordenar clientes). Elegir C maximizando el porcentaje de aciertos es usar la métrica ciega de la primera dinámica —la que empataba a los tres modelos— para calibrar el único parámetro que controla el trade-off sesgo-varianza del modelo.
En la práctica: LogisticRegressionCV(scoring="neg_log_loss").
Resumen
| Ridge (L2) | Lasso (L1) | |
|---|---|---|
| Efecto en los coeficientes | Los encoge; ninguno llega a cero | Manda a cero los irrelevantes |
| Separación perfecta | La controla | La controla |
| Multicolinealidad | Reparte el efecto entre las correlacionadas | Escoge una y apaga las demás |
| Cuándo usarla | Todas las variables aportan algo; se busca estabilidad | Se busca un modelo corto y auditable |
Solver en scikit-learn |
lbfgs (default) |
saga o liblinear |
Clusterización con K-Means: Estructurando el Caos
Dejamos la predicción y entramos al descubrimiento con K-Means, el algoritmo de aprendizaje no supervisado más popular para la segmentación.
El Problema de Negocio
Cuando una empresa tiene miles o millones de clientes, es imposible tratarlos individualmente. Necesitamos agruparlos en segmentos con características similares para diseñar estrategias diferenciadas:
- Campañas de marketing dirigidas
- Niveles de servicio personalizados
- Estrategias de precios segmentadas
- Desarrollo de productos para nichos específicos
Intuición del Algoritmo
K-Means es un algoritmo geométrico iterativo que intenta encontrar “centros de gravedad” en los datos.
El Proceso (4 Pasos)
1. Inicialización
- Decidimos cuántos grupos queremos encontrar (\(K\), digamos \(K=3\))
- El algoritmo coloca 3 puntos (centroides) al azar en el espacio de datos
2. Asignación
- Cada cliente (punto de datos) se asigna al centroide que le quede más cerca (distancia Euclidiana)
- Esto crea “territorios” o Celdas de Voronoi
3. Actualización
- Una vez formados los grupos temporales, el algoritmo calcula el verdadero centro geométrico (promedio) de todos los puntos del grupo
- Mueve el centroide a esa nueva posición
4. Iteración
- Al moverse el centroide, algunos puntos podrían quedar ahora más cerca de otro centroide diferente
- Se repiten los pasos 2 y 3 hasta que los centroides dejan de moverse (convergencia)
El Rol Crítico de la Estandarización de Datos
En la fase de Preparación de Datos de CRISP-DM, K-Means exige un cuidado especial.
Problema: K-Means utiliza distancias, por lo que es extremadamente sensible a las escalas de las variables.
Ejemplo:
- Variable A: Ingresos ($20,000 - $100,000)
- Variable B: Edad (18 - 65)
Numéricamente, una diferencia de $10,000 en ingresos eclipsará totalmente una diferencia de 40 años en edad.
Solución: Normalizar los datos (e.g., usando Z-scores) para poner todas las variables en la misma escala.
Si no normalizamos, el algoritmo ignorará la edad y solo agrupará por ingresos. Este es un error técnico común que lleva a conclusiones de negocio erróneas.
Selección del Número Óptimo de Clusters (\(K\))
¿Cómo decidimos cuántos grupos crear?
1. Método del Codo (Elbow Method)
- Ejecutar K-Means para diferentes valores de \(K\) (e.g., 1-10)
- Graficar la inercia (suma de distancias al centroide más cercano)
- Buscar el “codo” donde agregar más clusters produce rendimientos decrecientes
2. Índice de Silueta (Silhouette Score)
- Mide qué tan bien definidos están los clusters
- Valores cercanos a 1 indican clusters bien separados
3. Validación de Negocio
- ¿Los clusters permiten tomar acciones diferentes?
- ¿Son interpretables para el equipo de marketing?
Interpretación de los Clusters: Profiling
La salida de K-Means es simplemente una etiqueta: “Cliente 001 pertenece al Cluster 2”. El trabajo del ingeniero es dar sentido a eso mediante el Perfilamiento.
Calculamos los promedios de cada variable para cada cluster:
| Cluster | Edad Promedio | Gasto Mensual | Frecuencia Web | Interpretación |
|---|---|---|---|---|
| A | 22 | $150 | Alta | “Estudiantes Digitales” |
| B | 45 | $800 | Baja | “Profesionales Ocupados” |
| C | 35 | $300 | Media | “Familias Conscientes del Presupuesto” |
Estos perfiles se traducen directamente en estrategias de marketing diferenciadas:
- Cluster A: Descuentos estudiantiles, experiencia mobile-first, redes sociales
- Cluster B: Servicio premium, conveniencia, compra rápida
- Cluster C: Valor por dinero, bundles familiares, programas de lealtad